
Dokumentation aus Code generieren: Was KI richtig macht und was falsch
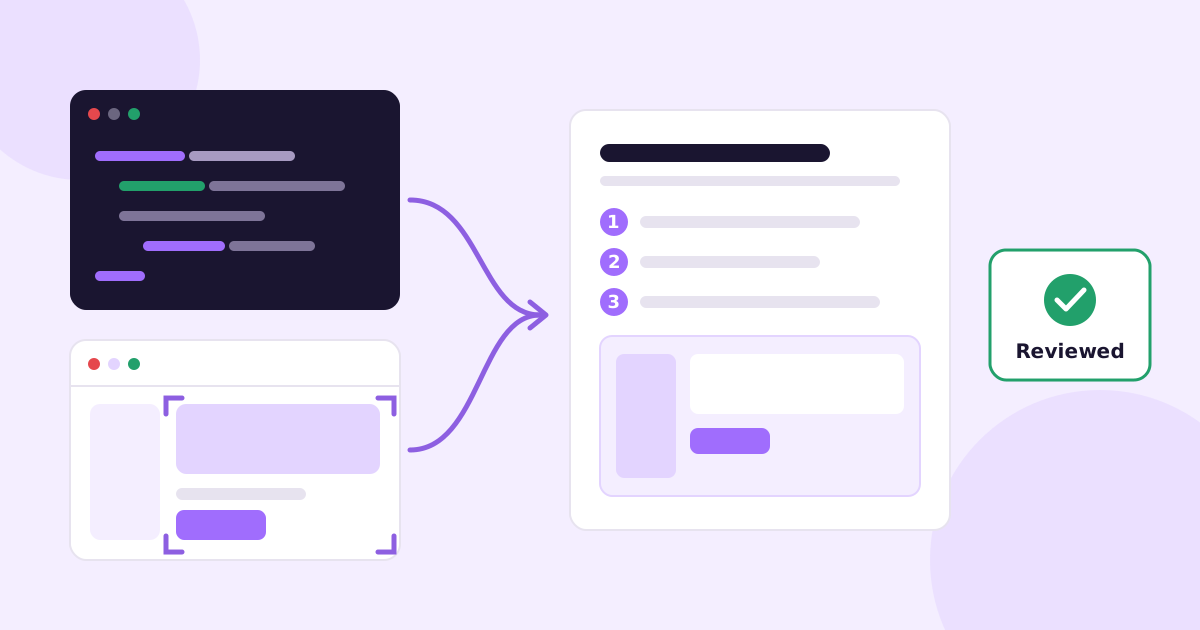
Richten Sie ein Modell auf ein Repository, bitten Sie um ein Help-Center, und Sie bekommen eines. Es sieht fertig aus. Dann lesen Sie Artikel vier, und er erzählt Ihren Kunden etwas über PlanTier.PRO_LEGACY und eine Seite unter /admin/impersonate.
Kann KI also Dokumentation aus Code generieren? Ja, und die Entwürfe sind nützlich. KI findet zuverlässig jede Funktion, trifft Beschriftungen von Schaltflächen genau und liefert einen einheitlichen ersten Durchgang. Direkt aus dem Modell macht sie aber regelmäßig drei Dinge falsch: Sie lässt interne Fachbegriffe durchsickern, dokumentiert Seiten, die Ihre Nutzer gar nicht sehen können, und beschreibt den Code statt der Aufgabe, die der Nutzer erledigen will. Die Lösung besteht darin, die Entwürfe an der laufenden App zu verankern und alles vor der Veröffentlichung von einem Menschen prüfen zu lassen.
Hier steht, warum das so ist und wie Sie alles so aufsetzen, dass das Ergebnis veröffentlichungsreif ist.
Zwei sehr verschiedene Arten von „Dokumentation aus Code“
Wer danach sucht, meint zwei verschiedene Dinge, und es lohnt sich, sie zu trennen.
Referenzdokumentation für Entwickler. API-Referenzen, SDK-Dokumentation, Funktionssignaturen. Das ist weitgehend ein gelöstes Problem und braucht gar keine KI. TypeDoc, Sphinx autodoc, Javadoc und OpenAPI-Werkzeuge wie Swagger UI lesen Ihren Code oder Ihre Spezifikation und erzeugen Referenzseiten deterministisch. Sie sind unspektakulär und verlässlich, genau das, was man von Referenzdokumentation will.
Nutzerdokumentation. Hilfeartikel für Menschen, die Ihren Code nie sehen werden: „Wie exportiere ich meine Rechnungen?“, „Wie füge ich einen Kollegen hinzu?“. Das ist die schwierige Variante, und hier sind KI-Dokumentationsgeneratoren inzwischen wirklich nützlich und wirklich riskant.
Dieser Beitrag handelt von der zweiten Art. Wenn Sie eine README oder Code-Kommentare brauchen, erledigt Ihr Coding-Assistent das bereits gut genug.
Was KI gut kann, wenn sie Nutzerdokumentation aus Code erzeugt
Anerkennung, wo sie gebührt. Ein Modell, das eine Codebasis liest, ist bei ein paar bestimmten Aufgaben besser als ein Mensch.
Sie findet alles
Menschen schreiben Dokumentation aus dem Gedächtnis, und das Gedächtnis vergisst Funktionen. Den CSV-Import, den jemand vor acht Monaten gebaut hat. Das Tastenkürzel. Die Einstellung, die nur im Team-Tarif erscheint. Ein Modell, das Ihre Routen-Datei, Navigationskomponenten und Formulare liest, erzeugt ein vollständiges Inventar, und allein dieses Inventar ist die Übung wert. Die meisten Help-Center haben Lücken, von denen niemand weiß.
Sie trifft die genauen Beschriftungen
Der Text der Schaltfläche steht direkt im Code: "Export CSV", "Send invite". Ein Modell zitiert ihn exakt, während ein Mensch „klicken Sie auf die Export-Schaltfläche“ schreibt und den Leser raten lässt.
Sie bemerkt Grenzen und Regeln
Validierungsregeln stehen im Code. Eine maximale Länge für einen Projektnamen, eine Obergrenze für die Dateigröße, eine Rollenprüfung, die eine Schaltfläche ausgraut. Genau diese Details erzeugen Support-Tickets („Warum kann ich das nicht speichern?“), und genau diese Details kennt ein menschlicher Autor nicht.
Was KI falsch macht, wenn sie Dokumentation aus Code generiert
Das ist der Teil, den die meisten Tools nicht auf ihre Startseite schreiben. Nach meiner Erfahrung tauchen diese Fehlerbilder in fast jedem rohen KI-Entwurf auf.
1. Interne Fachbegriffe sickern durch
Ihr Code und Ihre Oberfläche verwenden unterschiedliche Wörter. Die Tabelle heißt workspaces, die Oberfläche sagt „Team“. Die Enum heißt PlanTier.PRO_LEGACY, die Preisseite sagt „Pro“. Die Funktion hieß intern ein Jahr lang smartRouting, bevor das Marketing sie „Auto-assign“ nannte.
Das Modell liest den Code, also verwendet es Code-Wörter. Sie bekommen Sätze wie „Erstellen Sie auf der Seite „Teams“ einen neuen Workspace (Org)“, was für Kunden verwirrend und außerdem falsch ist. Schlimmer noch: Es gibt Namen preis, die nie öffentlich werden sollten.
2. Sie dokumentiert Seiten, die Ihre Nutzer nicht sehen können
Ein Modell sieht eine Route und schreibt dazu einen Artikel. Es hat keine Ahnung, dass:
/admin/*Ihr internes Support-Werkzeug ist- die Seite „Bulk import“ hinter einem Feature-Flag liegt, das für drei Beta-Konten aktiv ist
- die Einstellungen unter „Teams“ nur im Business-Tarif angezeigt werden
- der alte Onboarding-Ablauf toter Code ist, den niemand entfernt hat
Also schreibt es Hilfeartikel zu allem. Im besten Fall suchen Kunden nach Seiten, die es für sie gar nicht gibt, und schreiben Ihnen. Im schlimmsten Fall haben Sie Ihre Roadmap veröffentlicht oder eine Anleitung für Ihr Admin-Werkzeug zum Übernehmen fremder Konten.
3. Sie beschreibt den Code statt der Aufgabe des Nutzers
Das ist der subtile Punkt und der häufigste. Ein Modell erklärt, was der Code tut, weil es genau das vor sich hat. Nutzer interessiert nicht, was der Code tut. Sie wollen etwas erledigen.
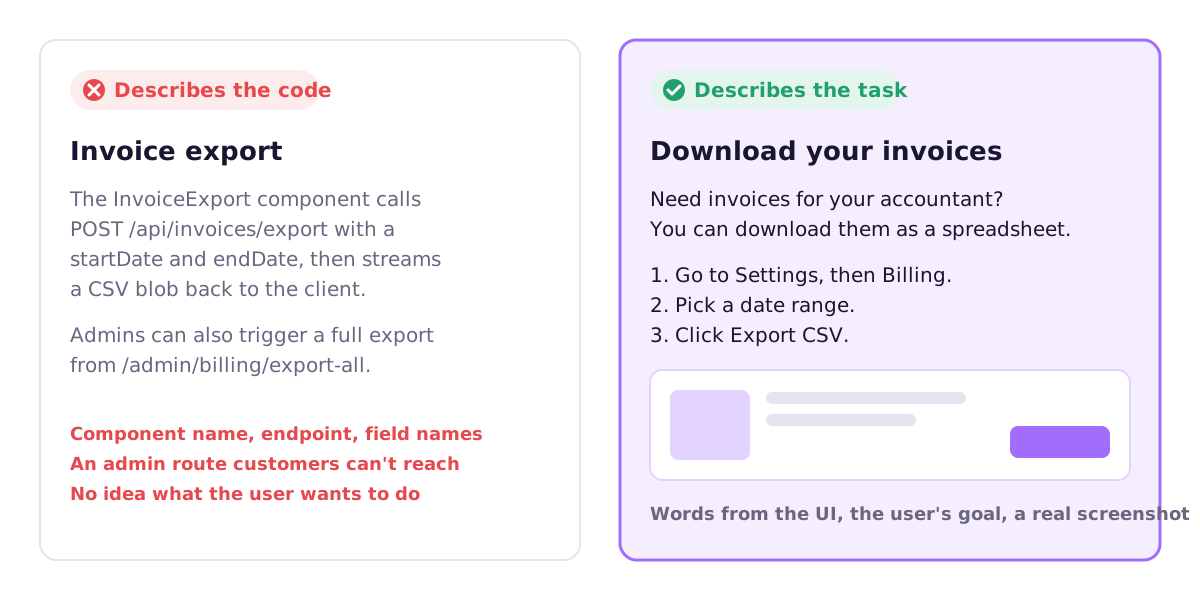
Die linke Version ist korrekt. Für jemanden, dessen Steuerberater gerade die Rechnungen des letzten Quartals angefordert hat, ist sie trotzdem nutzlos. Die rechte Version geht vom Ziel aus, verwendet die Wörter auf dem Bildschirm und zeigt, wohin man klickt. Das Diátaxis-Framework zieht diese Linie gut: Eine Anleitung dient einem Ziel, eine Referenz beschreibt die Maschinerie. Rohe KI-Entwürfe driften in Richtung Referenz, selbst wenn Sie eine Anleitung bestellt haben.
4. Sie rät selbstsicher bei Verhalten, das der Code nicht festlegt
Vieles, was Nutzer erleben, wird nicht allein durch den Code bestimmt. Ob eine Bestätigungs-E-Mail tatsächlich versendet wird, hängt von der Konfiguration ab. Wie eine Seite aussieht, hängt von den Daten darin ab. Ihre Erstattungsrichtlinie, Ihre Support-Zeiten und was nach einer Kündigung mit den Daten passiert, stehen meist gar nicht im Repository.
Ein Modell füllt diese Lücken mit plausiblen Vermutungen im selben selbstsicheren Ton wie alles andere. Das ist das Gefährliche: Die falschen Sätze sehen nicht anders aus als die richtigen.
Warum die Verankerung an der laufenden App wichtig ist
Der Code zeigt, was existieren kann. Die laufende App zeigt, was ein Nutzer tatsächlich sieht.
Wenn Sie Dokumentation allein aus Code generieren, dokumentieren Sie eine Theorie Ihres Produkts. Starten Sie die App, melden Sie sich als normaler Nutzer in einem normalen Tarif an, und die meisten der genannten Probleme schrumpfen:
- Admin-Seiten und Seiten hinter Feature-Flags erscheinen schlicht nicht und werden deshalb nicht dokumentiert.
- Die Beschriftungen auf dem Screenshot sind die Beschriftungen, die Kunden sehen, was Fachjargon aufdeckt.
- Steht im Artikel „Klicken Sie auf Export CSV“ und der Screenshot zeigt keine Export-Schaltfläche, haben Sie einen Fehler gefunden (in der Dokumentation oder im Produkt), bevor ein Kunde es getan hat.
Das können Sie selbst mit einem Werkzeug zur Browser-Automatisierung machen. Ein minimales Playwright-Skript, das sich als Demo-Nutzer anmeldet und eine Seite für einen Artikel aufnimmt, sieht so aus:
// docs/capture/billing.spec.ts
import { test } from '@playwright/test';

test('capture billing page for the invoices article', async ({ page }) => {
  await page.goto('http://localhost:3000/login');
  await page.getByLabel('Email').fill('docs-demo@example.com');
  await page.getByLabel('Password').fill(process.env.DOCS_DEMO_PASSWORD!);
  await page.getByRole('button', { name: 'Sign in' }).click();

  await page.goto('http://localhost:3000/settings/billing');
  await page.screenshot({ path: 'docs/img/download-invoices-step-1.png' });
});
Die Playwright-Dokumentation zu Screenshots behandelt Aufnahmen einzelner Elemente und ganzer Seiten. Das Schwierige ist nicht das Skript, sondern der Besitz von echt aussehenden Demo-Daten und einem Login, der in der CI funktioniert. Das gesamte Setup gehen wir in Produkt-Screenshots automatisch erstellen durch.
Warum menschliche Prüfung trotzdem nicht optional ist
Selbst bei guter Verankerung muss jemand, der das Produkt kennt, jeden Artikel lesen, bevor er live geht. Nicht überfliegen. Lesen.
Hier die Checkliste, die ich einem Prüfer mitgeben würde:
- Die Wörter stimmen mit der Oberfläche überein. Jeder Funktionsname, jede Schaltfläche und jeder Menüpunkt entspricht dem, was Kunden sehen, nicht dem, was Entwickler sagen.
- Jede Seite ist erreichbar. Ein Kunde in dem Tarif, auf den der Artikel zielt, kommt tatsächlich dorthin. Tarifspezifische Funktionen sagen das.
- Er beginnt bei der Aufgabe. Der Titel ist etwas, das ein Nutzer in die Suche eintippen würde. Der erste Schritt ist ein Klick, kein Absatz mit Hintergrund.
- Richtlinien sind echt. Alles zu Geld, Daten, Kündigung oder Support-Zeiten stammt von Ihnen, nicht vom Modell.
- Nichts Unveröffentlichtes. Keine Beta-Funktionen, keine internen Werkzeuge, keine Namen, die das Marketing nicht angekündigt hat.
Einen ordentlichen Entwurf zu prüfen geht viel schneller, als von einer leeren Seite zu schreiben, und genau das ist der Sinn. Aber dieser Schritt macht aus einem plausiblen Entwurf eine Dokumentation, hinter der Sie stehen. Wenn Sie ihn überspringen, veröffentlichen Sie die Vermutungen des Modells unter dem Namen Ihres Unternehmens.
Ein DIY-Ablauf, den Sie mit Ihrem Coding-Assistenten umsetzen können
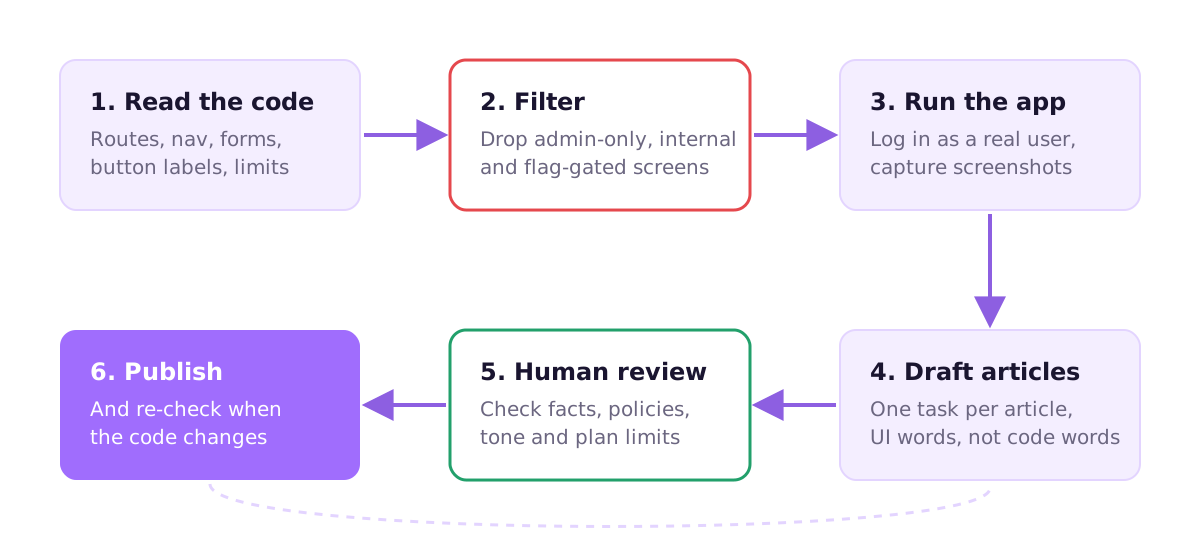
Sie brauchen keinen speziellen KI-Dokumentationsgenerator, um den größten Teil des Nutzens zu erhalten. Mit Cursor, Claude Code, Copilot oder ähnlichen Werkzeugen:
1. Bitten Sie um ein Inventar, nicht um Artikel. Zum Beispiel so:
List every user-facing feature in this app. For each one give:
- the route or screen where a user finds it
- the exact button/menu labels involved
- any plan, role or feature-flag check guarding it
Do not write documentation yet.
2. Bereinigen Sie es von Hand. Streichen Sie Admin-Routen, interne Werkzeuge, Betas hinter Flags und toten Code. Das dauert zehn Minuten und verhindert die schlimmsten Fehler.
3. Geben Sie ihm ein Glossar. Eine kurze Liste, die Code-Begriffe auf Begriffe der Oberfläche abbildet (workspace → Team, PRO_LEGACY → Pro). Fügen Sie sie in jeden Entwurfs-Prompt ein.
4. Entwerfen Sie eine Aufgabe pro Artikel. Bitten Sie um eine Anleitung für nicht technische Nutzer, die nur Beschriftungen aus dem Inventar verwendet, beim Ziel beginnt und jeden Satz, bei dem das Modell unsicher ist, mit [CHECK] kennzeichnet.
5. Gehen Sie die App durch und machen Sie Screenshots. Folgen Sie jedem Artikel selbst. Korrigieren Sie, was falsch ist, und fügen Sie Screenshots hinzu.
6. Prüfen Sie anhand der obigen Checkliste und veröffentlichen Sie dann. Für die Struktur bietet Hilfeartikel schreiben, die Menschen wirklich nutzen eine Vorlage, die hier gut passt.
Die Schwäche des DIY-Wegs ist Schritt 7, den es noch nicht gibt: zu bemerken, wenn die Code-Änderung der nächsten Woche Artikel zwölf falsch macht. Das ist ein eigenes Problem, das Dokumentation aktuell halten behandelt.
Wie Ellie Docs das löst
Wir haben Ellie Docs rund um die oben genannten Fehlerbilder gebaut, hier also, wie es dazu passt.
Es liest Ihr Repository und ordnet Funktionen und nutzersichtbare Seiten zu, und entwirft dann ein Help-Center, das nach dem aufgebaut ist, was Nutzer tun.
Es startet Ihre App in einer Sandbox und nimmt echte Screenshots des angemeldeten Produkts auf, die in die Artikel eingefügt werden. Jeder Artikel zeigt, an welchen Funktionen er verankert ist. Ändern sich diese Funktionen im Code, weiß Ellie, dass der Artikel betroffen sein könnte.

Bei jedem gemergten PR prüft es, welche Artikel von der Änderung betroffen sind, und schlägt Änderungen als Diff vor, den Sie annehmen oder verwerfen. Wenn es Ihr Changelog aus gemergten PRs schreibt, hält es Einträge zu unveröffentlichter Arbeit oder Arbeit hinter Feature-Flags zurück. Nichts wird von allein veröffentlicht. Sie veröffentlichen.
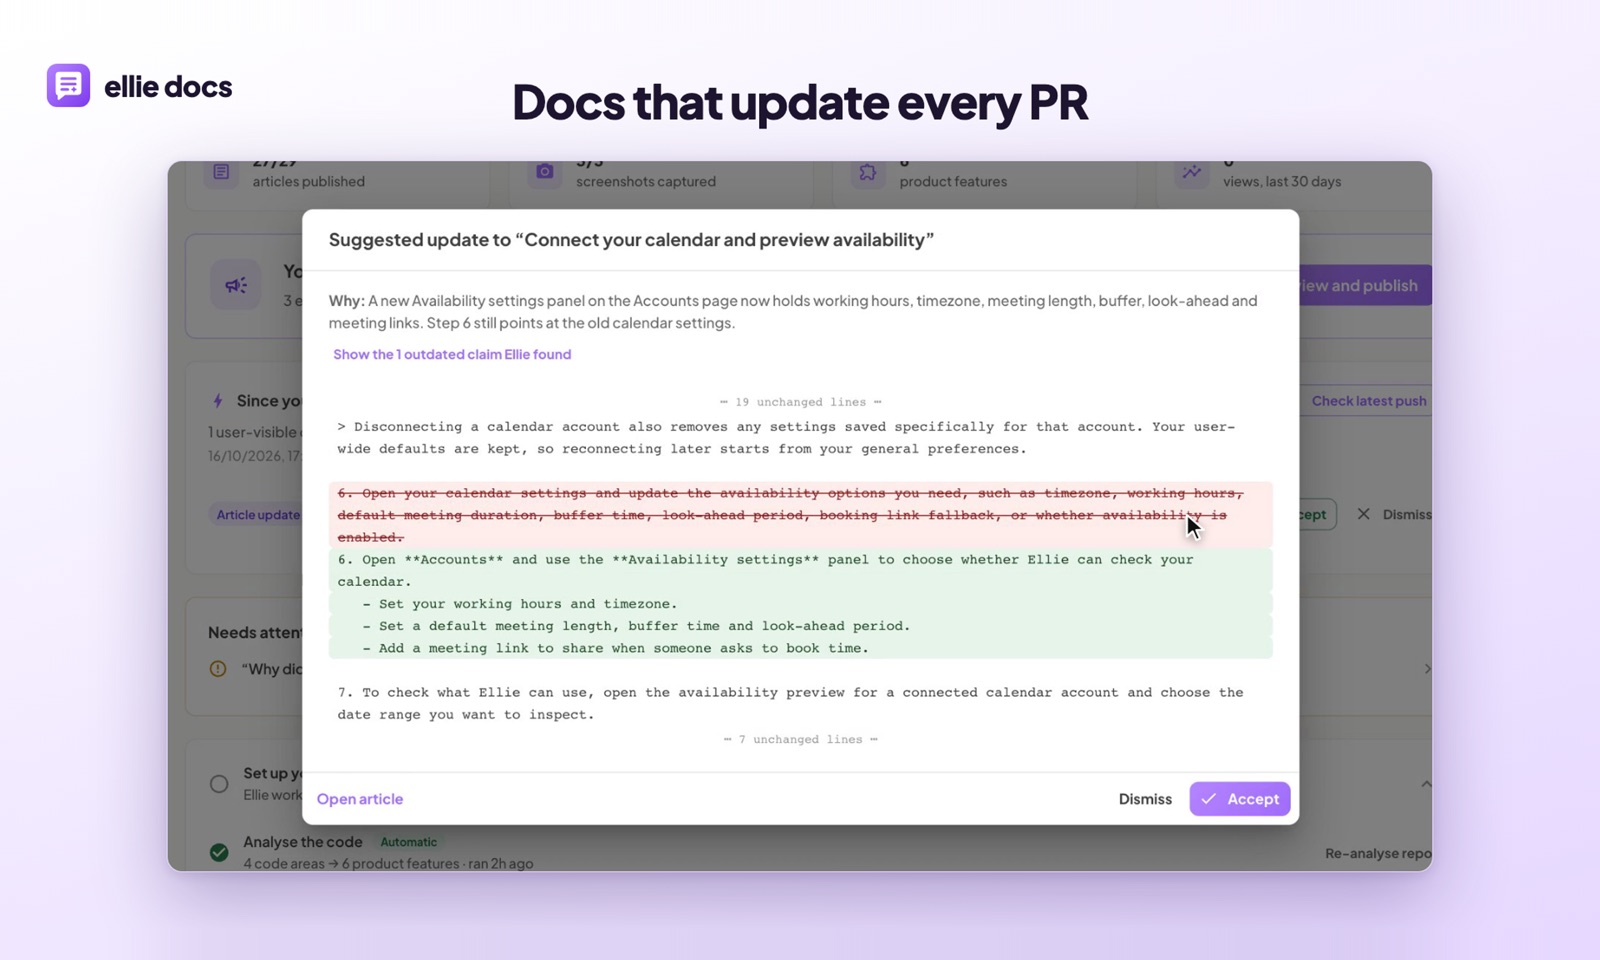
Es macht trotzdem manchmal Fehler. Es kennt Ihre Richtlinien nicht und wählt gelegentlich ein Code-Wort statt eines Wortes der Oberfläche. Deshalb geht jeder Entwurf und jeder Vorschlag über Ihren Tisch. Wenn Sie an einer App arbeiten, die mit einem KI-Builder gebaut wurde, behandelt der Leitfaden zum Dokumentieren einer Vibe-Coding-App die zusätzlichen Besonderheiten.
Ein paar Fragen, die Menschen stellen
Gibt es einen kostenlosen KI-Dokumentationsgenerator? Ihr Coding-Assistent plus der obige DIY-Ablauf kostet nichts extra. Ellie Docs hat außerdem einen kostenlosen Tarif ohne Karte, wenn Sie lieber Screenshots und Update-Verfolgung abgenommen bekommen möchten.
Kann KI API-Dokumentation ohne OpenAPI-Spezifikation erzeugen? Sie kann es, indem sie Ihre Route-Handler liest. Wenn Sie bereits eine Spezifikation haben, nutzen Sie Standardwerkzeuge wie Swagger UI oder Redoc. Das ist deterministisch und kostenlos. Ellie Docs erzeugt in seinem Growth-Tarif eine API-Referenz aus dem Code ohne Spezifikation, was hilft, wenn Sie nie eine geschrieben haben.
Sollte ich KI Dokumentation automatisch veröffentlichen lassen? Nein. Lassen Sie sie entwerfen und vorschlagen. Eine Person, die das Produkt kennt, sollte alles freigeben, was Kunden lesen werden, besonders alles zu Abrechnung oder Daten.
Ist KI-geschriebene Dokumentation korrekt? So korrekt wie die Verankerung und die Prüfung dahinter. Aus dem Code allein ist ein nützlicher Entwurf mit selbstsicheren Fehlern zu erwarten. Verankert an der laufenden App und geprüft von jemandem, der das Produkt kennt, kann sie besser sein als das, was die meisten Teams von Hand schreiben, vor allem weil sie Funktionen abdeckt, die Menschen vergessen haben.
Wenn Sie Entwürfe wollen, die an Ihrer echten App verankert sind, mit Screenshots und Vorschlägen pro PR, die Sie freigeben, testen Sie Ellie Docs kostenlos. Verbinden Sie ein Repository und prüfen Sie noch heute Ihr erstes entworfenes Help-Center.