
Generar documentación a partir del código: en qué acierta y en qué falla la IA
Apunta un modelo a un repositorio, pídele un centro de ayuda y te lo dará. Parecerá terminado. Hasta que leas el artículo cuatro y veas que cuenta a tus clientes cosas sobre PlanTier.PRO_LEGACY y una pantalla en /admin/impersonate.
Entonces, ¿puede la IA generar documentación a partir del código? Sí, y los borradores son útiles. La IA es buena para encontrar todas las funciones, acertar con los nombres de los botones y producir una primera versión coherente. Pero, tal como sale del modelo, falla de forma sistemática en tres cosas: filtra jerga interna, documenta pantallas que tus usuarios no pueden ver y describe el código en lugar de la tarea que el usuario intenta hacer. La solución es fundamentar los borradores en la app en ejecución y hacer que una persona revise todo antes de publicarlo.
Aquí explicamos por qué y cómo montarlo para que el resultado merezca publicarse.
Dos tipos muy distintos de «documentación a partir del código»
Cuando la gente busca esto, se refiere a dos cosas y conviene separarlas.
Documentación de referencia para desarrolladores. Referencias de API, documentación de SDK, firmas de funciones. Es un problema en su mayor parte resuelto y no necesita IA en absoluto. Herramientas como TypeDoc, Sphinx autodoc, Javadoc y las de OpenAPI como Swagger UI leen tu código o tu especificación y producen páginas de referencia de forma determinista. Son aburridas y fiables, que es justo lo que quieres de una documentación de referencia.
Documentación de usuario. Artículos de un centro de ayuda para personas que nunca verán tu código: «cómo exporto mis facturas», «cómo añado a un compañero». Es la parte difícil, y es donde los generadores de documentación con IA son ahora realmente útiles y realmente arriesgados.
Esta entrada trata del segundo tipo. Si necesitas un README o comentarios de código, tu asistente de programación ya lo hace lo bastante bien.
Lo que la IA hace bien al generar documentación de usuario a partir del código
Hay que reconocer lo que es mérito suyo. Un modelo que lee una base de código es mejor que una persona en algunas tareas concretas.
Lo encuentra todo
Las personas escriben la documentación de memoria, y la memoria olvida funciones. La importación de CSV que alguien construyó hace ocho meses. El atajo de teclado. El ajuste que solo aparece en el plan de equipo. Un modelo que lee tu archivo de rutas, tus componentes de navegación y tus formularios produce un inventario completo, y solo ese inventario ya justifica el ejercicio. La mayoría de los centros de ayuda tienen lagunas que nadie conoce.
Acierta con los nombres exactos
El texto de los botones está ahí mismo en el código: "Export CSV", "Send invite". Un modelo lo citará tal cual, mientras que una persona escribe «haz clic en el botón de exportar» y deja al lector adivinando.
Detecta límites y reglas
Las reglas de validación viven en el código. Una longitud máxima para el nombre de un proyecto, un límite de tamaño de archivo, una comprobación de rol que deja un botón en gris. Son justo los detalles que generan tickets de soporte («¿por qué no puedo guardar esto?») y justo los detalles que una persona redactora no conoce.
En qué falla la IA al generar documentación a partir del código
Esta es la parte que la mayoría de las herramientas no pone en su página de inicio. En mi experiencia, estos fallos aparecen en casi todos los borradores en bruto de la IA.
1. Se cuela la jerga interna
Tu código y tu interfaz usan palabras distintas. La tabla es workspaces, la interfaz dice «Equipo». El enum es PlanTier.PRO_LEGACY, la página de precios dice «Pro». La función se llamó smartRouting internamente durante un año antes de que marketing la bautizara como «Asignación automática».
El modelo lee el código, así que usa palabras del código. Te salen frases como «Crea un nuevo workspace (org) desde la página de Equipos», que confunde a los clientes y además es incorrecta. Peor aún, filtra nombres que nunca pensaste hacer públicos.
2. Documenta pantallas que tus usuarios no pueden ver
Un modelo ve una ruta y escribe un artículo sobre ella. No tiene ni idea de que:
/admin/*es tu herramienta interna de soporte- la página «Importación masiva» está detrás de un flag de funcionalidad que solo está activo para tres cuentas beta
- los ajustes de «Equipos» solo se muestran en el plan Business
- ese antiguo flujo de incorporación es código muerto que nadie eliminó
Así que escribe artículos de ayuda para todos ellos. En el mejor de los casos, los clientes buscan pantallas que no existen para ellos y te escriben. En el peor, has publicado tu hoja de ruta o una guía de tu herramienta de suplantación de administrador.
3. Describe el código en lugar de la tarea del usuario
Esta es la más sutil y la más común. Un modelo explica lo que hace el código, porque es lo que tiene delante. A los usuarios no les importa lo que hace el código. Quieren conseguir algo.
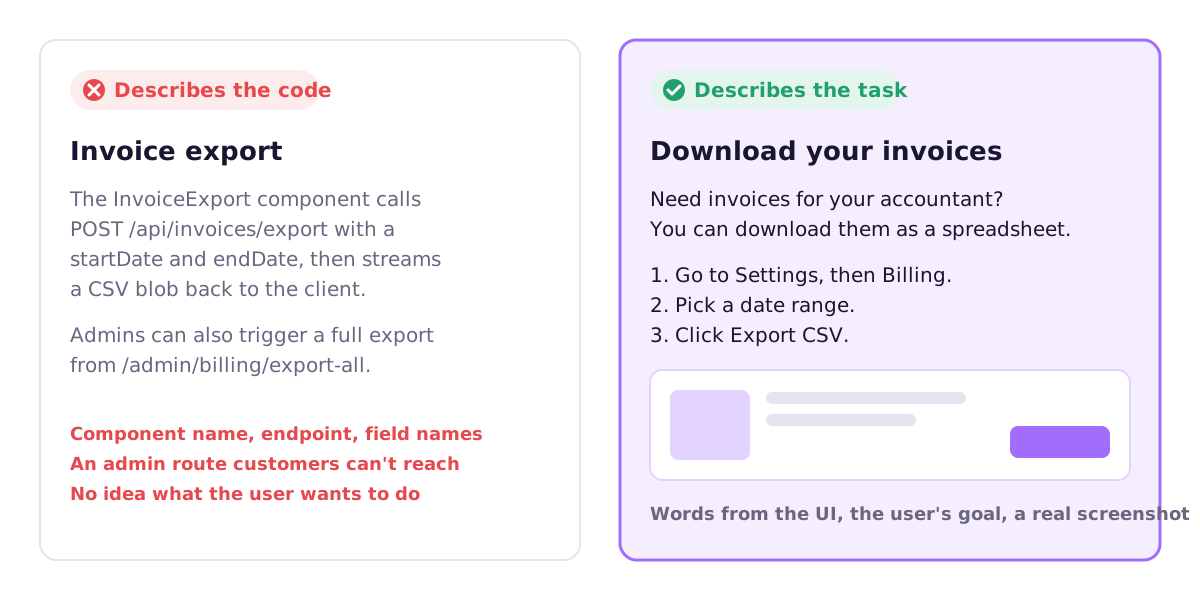
La versión de la izquierda es exacta. También es inútil para alguien cuyo contable acaba de pedirle las facturas del último trimestre. La versión de la derecha parte del objetivo, usa las palabras que aparecen en pantalla y muestra dónde hacer clic. El marco Diátaxis traza bien esta línea: una guía práctica sirve a un objetivo, una referencia describe la maquinaria. Los borradores en bruto de la IA derivan hacia la referencia incluso cuando pediste una guía práctica.
4. Adivina con aplomo comportamientos que el código no resuelve
Gran parte de lo que experimentan los usuarios no lo decide solo el código. Que un correo de confirmación se envíe de verdad depende de la configuración. Cómo se ve una página depende de los datos que contiene. Tu política de reembolsos, tu horario de soporte y lo que pasa con los datos tras la cancelación normalmente no están en el repositorio.
Un modelo rellena esos huecos con suposiciones verosímiles escritas con el mismo tono seguro que todo lo demás. Eso es lo peligroso: las frases erróneas no se distinguen de las correctas.
Por qué importa basar la documentación en la app en ejecución
El código te dice lo que puede existir. La app en ejecución muestra lo que un usuario ve de verdad.
Si generas documentación solo a partir del código, estás documentando una teoría de tu producto. Ejecuta la app, inicia sesión como un usuario normal en un plan normal y la mayoría de los problemas anteriores se reducen:
- Las pantallas de administración y las protegidas por flags sencillamente no aparecen, así que no se documentan.
- Los textos de la captura son los que ven los clientes, lo que detecta la jerga.
- Si el artículo dice «haz clic en Export CSV» y la captura no tiene un botón de exportar, has encontrado un error (en la documentación o en el producto) antes que un cliente.
Puedes hacerlo tú mismo con una herramienta de automatización del navegador. Un script mínimo de Playwright que inicia sesión como usuario de demostración y captura una página para un artículo sería así:
// docs/capture/billing.spec.ts
import { test } from '@playwright/test';

test('capture billing page for the invoices article', async ({ page }) => {
  await page.goto('http://localhost:3000/login');
  await page.getByLabel('Email').fill('docs-demo@example.com');
  await page.getByLabel('Password').fill(process.env.DOCS_DEMO_PASSWORD!);
  await page.getByRole('button', { name: 'Sign in' }).click();

  await page.goto('http://localhost:3000/settings/billing');
  await page.screenshot({ path: 'docs/img/download-invoices-step-1.png' });
});
La documentación de capturas de pantalla de Playwright explica las capturas de un solo elemento y de página completa. Lo difícil no es el script, sino tener datos de demostración sembrados que parezcan reales y un inicio de sesión que funcione en CI. Repasamos toda la configuración en cómo crear capturas de pantalla de producto automáticamente.
Por qué la revisión humana sigue sin ser opcional
Incluso con una buena base, alguien que conozca el producto tiene que leer cada artículo antes de que salga. No echarle un vistazo. Leerlo.
Esta es la lista de comprobación que le daría a un revisor:
- Las palabras coinciden con la interfaz. Cada nombre de función, botón y elemento de menú es lo que ven los clientes, no lo que dicen los ingenieros.
- Cada pantalla es accesible. Un cliente en el plan al que va dirigido el artículo puede llegar de verdad hasta allí. Las funciones propias de un plan lo indican.
- Parte de la tarea. El título es algo que un usuario escribiría en el buscador. El primer paso es un clic, no un párrafo de contexto.
- Las políticas son reales. Todo lo relativo a dinero, datos, cancelaciones u horarios de soporte viene de ti, no del modelo.
- Nada sin publicar. Sin funciones beta, sin herramientas internas, sin nombres que marketing no haya anunciado.
Revisar un borrador decente es mucho más rápido que escribir desde una página en blanco, que es justo la idea. Pero es el paso que convierte un borrador verosímil en documentación que puedes respaldar. Si te lo saltas, estás publicando las suposiciones del modelo con el nombre de tu empresa.
Un flujo casero que puedes ejecutar con tu asistente de programación
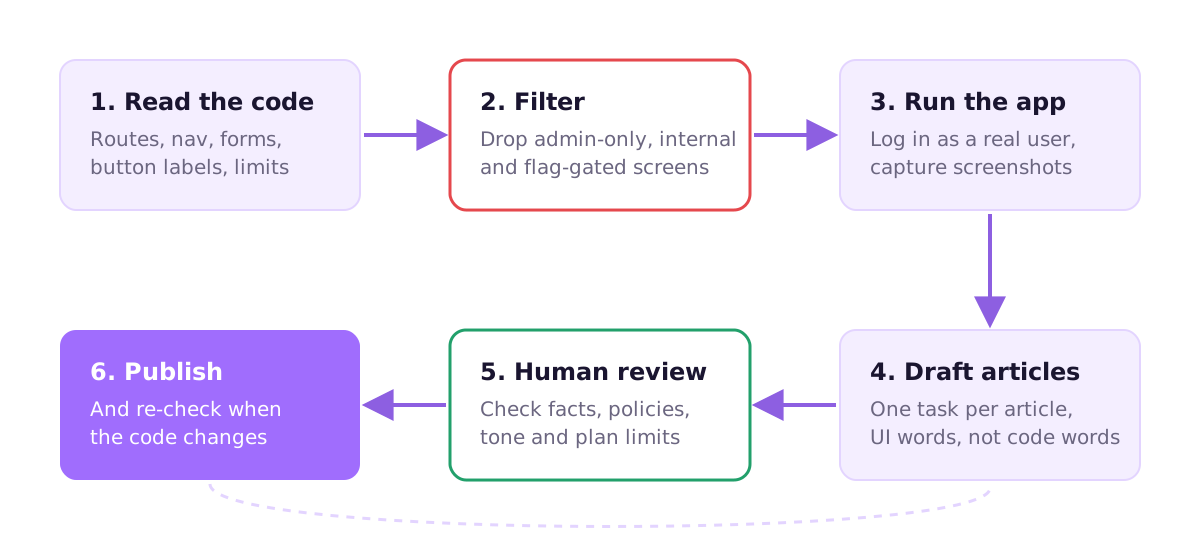
No necesitas un generador de documentación con IA específico para obtener la mayor parte del valor. Con Cursor, Claude Code, Copilot o similares:
1. Pide un inventario, no artículos. Algo como:
List every user-facing feature in this app. For each one give:
- the route or screen where a user finds it
- the exact button/menu labels involved
- any plan, role or feature-flag check guarding it
Do not write documentation yet.
2. Poda a mano. Tacha las rutas de administración, las herramientas internas, las betas protegidas por flags y el código muerto. Lleva diez minutos y evita los peores fallos.
3. Dale un glosario. Una lista corta que asocie los términos del código con los de la interfaz (workspace → Equipo, PRO_LEGACY → Pro). Pégala en cada instrucción de redacción.
4. Redacta una tarea por artículo. Pide una guía práctica escrita para un usuario no técnico, usando solo textos del inventario, que empiece por el objetivo y que marque con [CHECK] cualquier frase de la que no esté seguro.
5. Recorre la app y haz capturas. Sigue tú mismo cada artículo. Corrige lo que esté mal y añade capturas.
6. Revisa con la lista de comprobación anterior y publica. En cuanto a la estructura, cómo escribir artículos de centro de ayuda que la gente realmente use incluye una plantilla que encaja muy bien aquí.
La debilidad del flujo casero es el paso 7, que todavía no existe: darte cuenta de cuándo el cambio de código de la semana que viene deja mal el artículo doce. Es un problema aparte, que se aborda en cómo mantener la documentación al día.
Cómo lo resuelve Ellie Docs
Hemos creado Ellie Docs en torno a los fallos descritos arriba, así que veamos cómo encaja.
Lee tu repositorio y mapea las funciones y las pantallas de cara al usuario, y después redacta un centro de ayuda organizado según lo que hacen los usuarios.
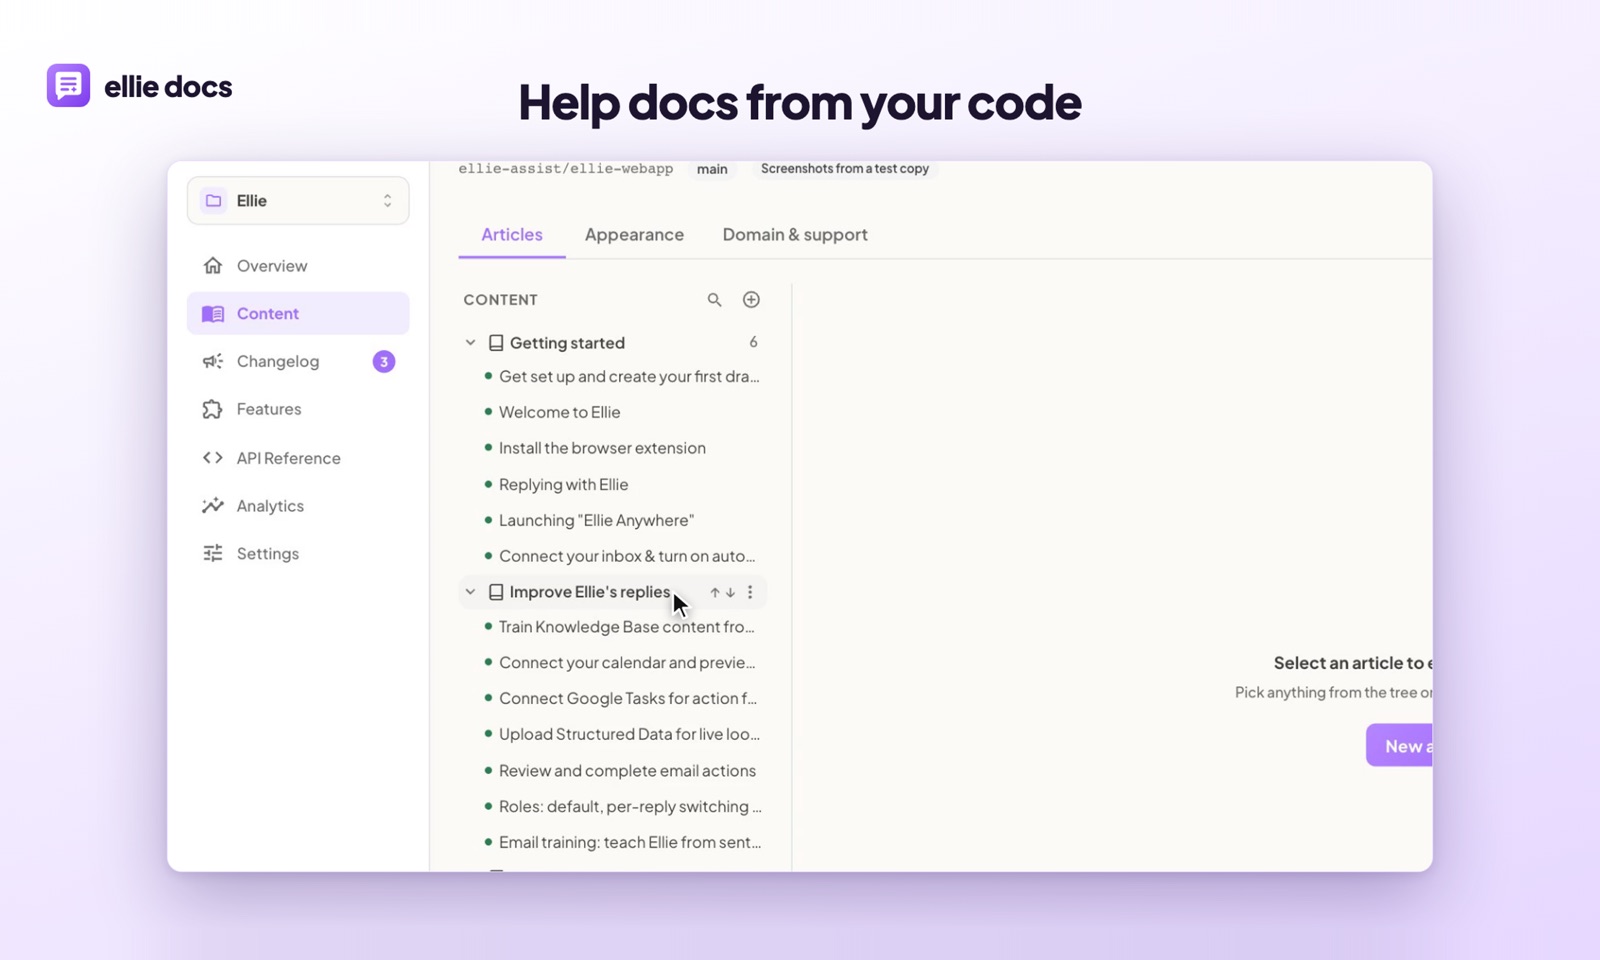
Ejecuta tu app en un entorno aislado y captura pantallas reales del producto con la sesión iniciada, que se colocan en los artículos. Cada artículo muestra en qué funciones se basa, de modo que, cuando esas funciones cambian en el código, Ellie sabe que el artículo puede verse afectado.

En cada PR fusionado, comprueba qué artículos toca el cambio y propone ediciones como un diff que aceptas o descartas. Cuando redacta tu registro de cambios a partir de los PR fusionados, retiene las entradas del trabajo sin publicar o protegido por flags. Nada se publica por sí solo. Publicas tú.
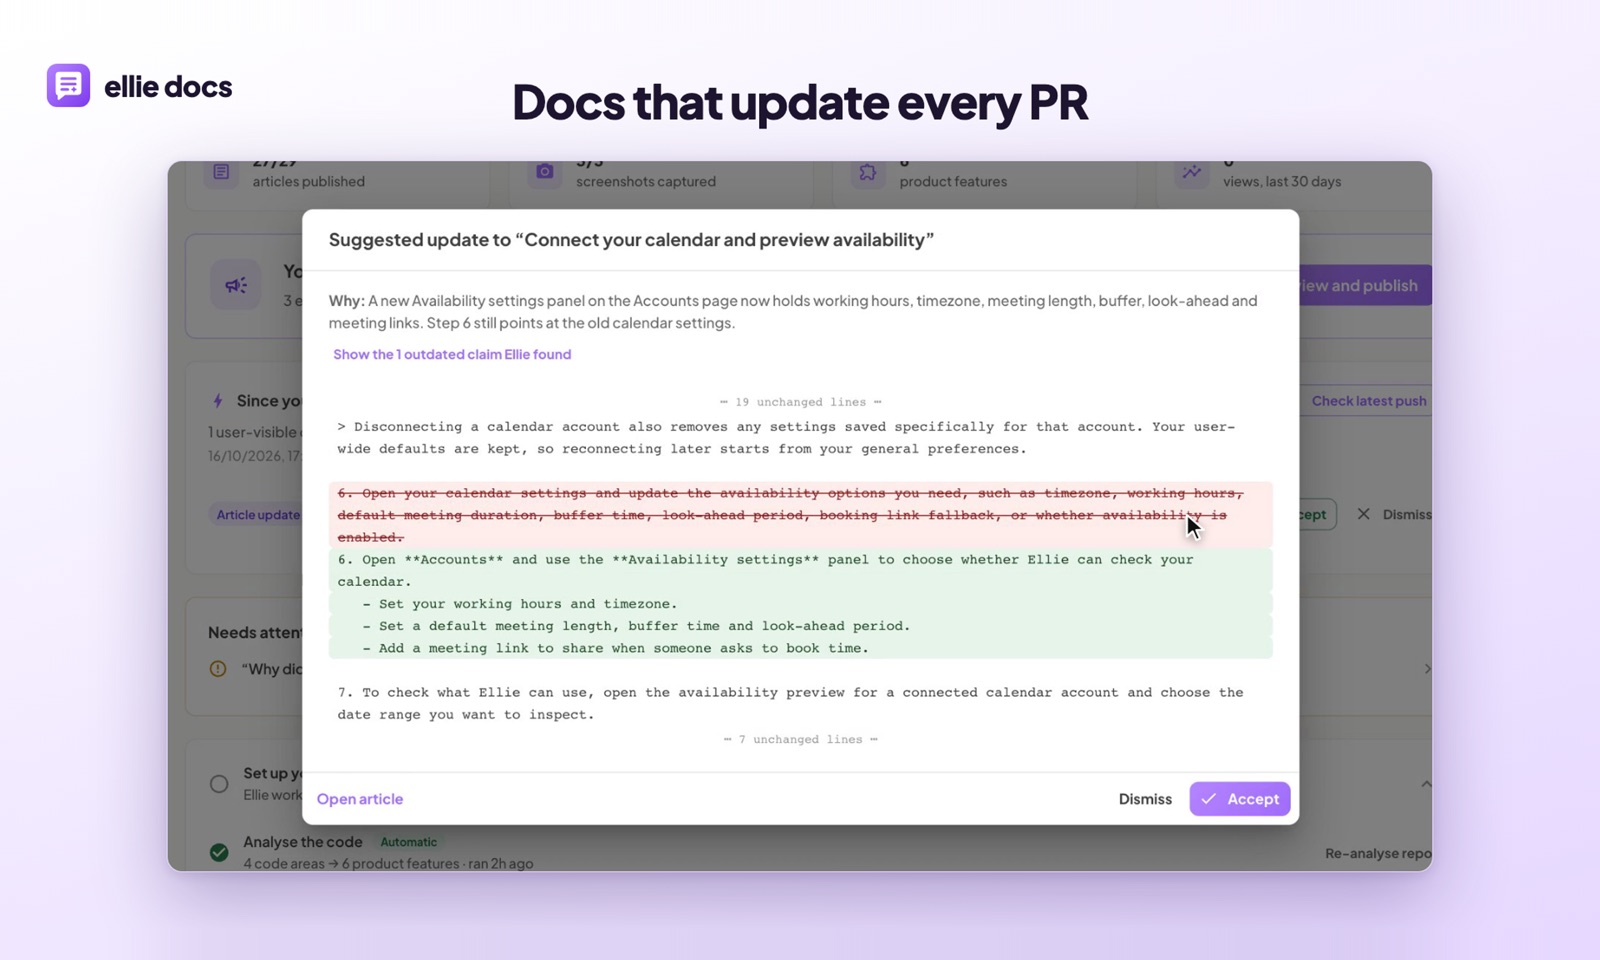
A veces sigue equivocándose. No puede conocer tus políticas y, de vez en cuando, elegirá una palabra del código en lugar de una de la interfaz. Por eso cada borrador y cada sugerencia pasan por ti. Si trabajas con una app creada con un generador de IA, la guía para documentar una app creada con vibe coding cubre las dificultades adicionales.
Algunas preguntas habituales
¿Existe un generador de documentación con IA gratuito? Tu asistente de programación más el flujo casero de arriba no cuesta nada extra. Ellie Docs también tiene un plan gratuito sin tarjeta, si prefieres que se encarguen por ti de las capturas y del seguimiento de actualizaciones.
¿Puede la IA generar documentación de API sin una especificación OpenAPI? Puede, leyendo tus controladores de rutas. Si ya tienes una especificación, usa herramientas estándar como Swagger UI o Redoc; es determinista y gratuito. Ellie Docs genera una referencia de API a partir del código sin especificación en su plan Growth, lo que ayuda si nunca escribiste una.
¿Debo dejar que la IA publique la documentación automáticamente? No. Deja que redacte y proponga. Una persona que conozca el producto debería aprobar todo lo que vayan a leer los clientes, especialmente lo relativo a facturación o datos.
¿Será precisa la documentación escrita por IA? Tan precisa como la base y la revisión que la respalden. Solo a partir del código, espera un borrador útil con errores cometidos con aplomo. Con base en la app en ejecución y revisada por alguien que conozca el producto, puede ser mejor que lo que escribe a mano la mayoría de los equipos, sobre todo porque cubre funciones que las personas olvidaron.
Si quieres borradores basados en tu app real, con capturas y sugerencias PR a PR que tú apruebas, prueba Ellie Docs gratis. Conecta un repositorio y revisa hoy mismo tu primer centro de ayuda redactado.