
Générer de la documentation à partir du code : ce que l'IA réussit et rate
Pointez un modèle sur un dépôt, demandez un centre d’aide, et vous en obtiendrez un. Il aura l’air terminé. Puis vous lisez l’article quatre et il parle à vos clients de PlanTier.PRO_LEGACY et d’un écran à l’adresse /admin/impersonate.
Alors, l’IA peut-elle générer de la documentation à partir du code ? Oui, et les brouillons sont utiles. L’IA est douée pour repérer chaque fonctionnalité, reproduire correctement les intitulés des boutons et produire une première version homogène. Mais telle qu’elle sort du modèle, elle se trompe systématiquement sur trois points : elle laisse fuiter du jargon interne, elle documente des écrans que vos utilisateurs ne voient pas, et elle décrit le code au lieu de la tâche que l’utilisateur essaie d’accomplir. La solution consiste à ancrer les brouillons dans l’application en fonctionnement et à faire relire l’ensemble par un humain avant publication.
Voici pourquoi, et comment procéder pour que le résultat vaille la peine d’être publié.
Deux types très différents de « documentation à partir du code »
Quand on cherche ce sujet, on parle de deux choses, et il vaut mieux les distinguer.
La documentation de référence pour développeurs. Références d’API, documentation de SDK, signatures de fonctions. C’est un problème en grande partie résolu, qui n’a pas besoin d’IA. TypeDoc, Sphinx autodoc, Javadoc et les outils OpenAPI comme Swagger UI lisent votre code ou votre spécification et produisent des pages de référence de façon déterministe. Ils sont ennuyeux et fiables, ce qu’on attend d’une documentation de référence.
La documentation utilisateur. Des articles de centre d’aide pour des personnes qui ne verront jamais votre code : « comment exporter mes factures », « comment ajouter un collègue ». C’est le cas difficile, et c’est là que les générateurs de documentation par IA sont aujourd’hui à la fois vraiment utiles et vraiment risqués.
Cet article porte sur le second type. Si vous avez besoin d’un README ou de commentaires de code, votre assistant de programmation s’en charge déjà assez bien.
Ce que l’IA fait bien quand elle génère de la documentation utilisateur à partir du code
Rendons à César ce qui est à César. Un modèle qui lit une base de code fait mieux qu’un humain sur quelques tâches précises.
Elle trouve tout
Les humains écrivent la documentation de mémoire, et la mémoire oublie des fonctionnalités. L’import CSV que quelqu’un a développé il y a huit mois. Le raccourci clavier. Le paramètre qui n’apparaît que sur l’offre Équipe. Un modèle qui lit votre fichier de routes, vos composants de navigation et vos formulaires produit un inventaire complet, et cet inventaire vaut à lui seul l’exercice. La plupart des centres d’aide ont des lacunes que personne ne connaît.
Elle reprend les intitulés exacts
Le texte des boutons est là, dans le code : "Export CSV", "Send invite". Un modèle le citera à l’identique, là où un humain écrit « cliquez sur le bouton d’export » et laisse le lecteur deviner.
Elle repère les limites et les règles
Les règles de validation vivent dans le code. Une longueur maximale pour un nom de projet, une limite de taille de fichier, un contrôle de rôle qui grise un bouton. Ce sont exactement les détails qui génèrent des tickets de support (« pourquoi je ne peux pas enregistrer ? ») et exactement ceux qu’un rédacteur humain ne connaît pas.
Ce que l’IA rate quand elle génère de la documentation à partir du code
C’est la partie que la plupart des outils ne mettent pas sur leur page d’accueil. D’après mon expérience, ces défauts apparaissent dans presque tous les brouillons bruts d’IA.
1. Le jargon interne fuit
Votre code et votre interface n’emploient pas les mêmes mots. La table s’appelle workspaces, l’interface dit « Team ». L’énumération est PlanTier.PRO_LEGACY, la page de tarifs dit « Pro ». La fonctionnalité s’est appelée smartRouting en interne pendant un an avant que le marketing la nomme « Auto-assign ».
Le modèle lit le code, donc il emploie les mots du code. Vous obtenez des phrases comme « Créez un nouveau workspace (org) depuis la page Teams », ce qui est déroutant pour les clients et en plus faux. Pire, cela révèle des noms que vous n’aviez jamais prévu de rendre publics.
2. Elle documente des écrans que vos utilisateurs ne voient pas
Un modèle voit une route et rédige un article pour elle. Il ne sait pas que :
/admin/*correspond à vos outils internes de support- la page « Bulk import » est derrière un drapeau de fonctionnalité activé pour trois comptes bêta
- les paramètres « Teams » ne s’affichent que sur l’offre Business
- cet ancien parcours d’accueil est du code mort que personne n’a supprimé
Il rédige donc des articles d’aide pour tout cela. Dans le meilleur des cas, des clients cherchent des écrans qui n’existent pas pour eux et vous écrivent. Dans le pire, vous avez publié votre feuille de route, ou un mode d’emploi de votre outil d’usurpation d’identité pour les administrateurs.
3. Elle décrit le code au lieu de la tâche de l’utilisateur
C’est le défaut le plus subtil, et le plus fréquent. Un modèle explique ce que fait le code, parce que c’est ce qu’il a sous les yeux. Les utilisateurs se moquent de ce que fait le code. Ils veulent accomplir quelque chose.
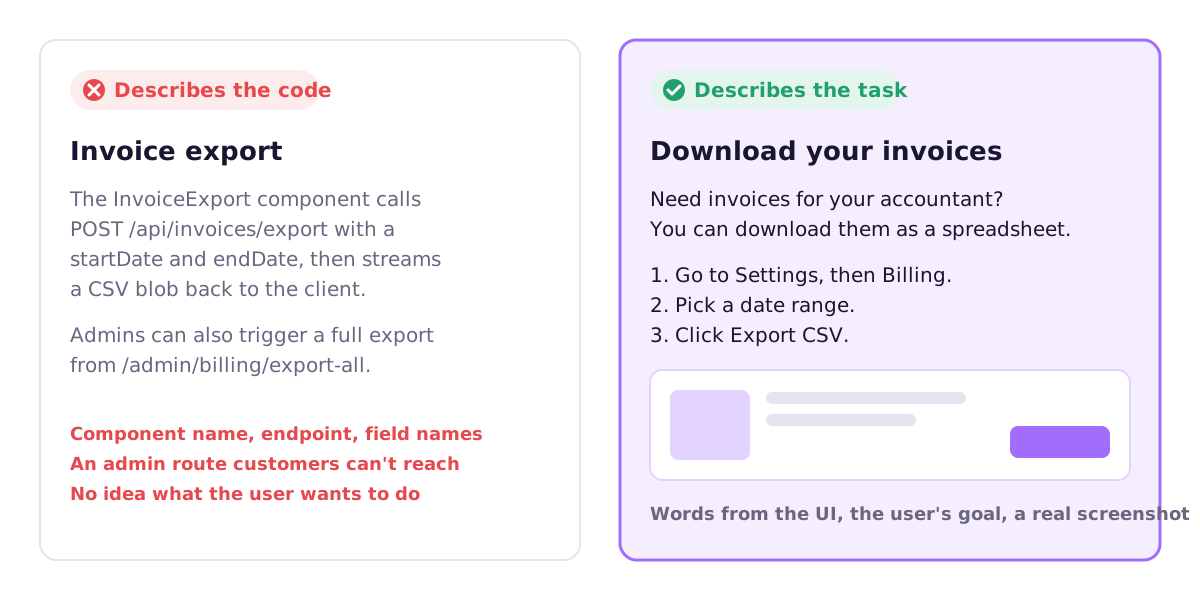
La version de gauche est exacte. Elle est aussi inutile pour quelqu’un dont le comptable vient de demander les factures du dernier trimestre. La version de droite part de l’objectif, utilise les mots affichés à l’écran et montre où cliquer. Le cadre Diátaxis trace bien cette frontière : un guide pratique sert un objectif, une référence décrit la mécanique. Les brouillons bruts d’IA dérivent vers la référence même quand on a demandé un guide pratique.
4. Elle devine avec aplomb des comportements que le code ne tranche pas
Beaucoup de ce que vivent les utilisateurs n’est pas décidé par le code seul. Savoir si un e-mail de confirmation part réellement dépend de la configuration. L’aspect d’une page dépend des données qu’elle contient. Votre politique de remboursement, vos horaires de support et ce qu’il advient des données après résiliation ne figurent généralement pas dans le dépôt.
Un modèle comble ces trous avec des suppositions plausibles, écrites sur le même ton assuré que tout le reste. C’est la partie dangereuse : les phrases fausses ne se distinguent en rien des phrases justes.
Pourquoi ancrer la documentation dans l’application en fonctionnement
Le code vous dit ce qui peut exister. L’application en fonctionnement montre ce que l’utilisateur voit réellement.
Si vous générez de la documentation à partir du code seul, vous documentez une théorie de votre produit. Lancez l’application, connectez-vous comme un utilisateur ordinaire sur une offre ordinaire, et la plupart des problèmes ci-dessus s’atténuent :
- Les écrans d’administration et ceux protégés par un drapeau n’apparaissent tout simplement pas, donc ils ne sont pas documentés.
- Les intitulés de la capture d’écran sont ceux que voient les clients, ce qui détecte le jargon.
- Si l’article dit « cliquez sur Export CSV » et que la capture ne montre aucun bouton d’export, vous avez trouvé une erreur (dans la documentation ou dans le produit) avant un client.
Vous pouvez le faire vous-même avec un outil d’automatisation de navigateur. Un script Playwright minimal qui se connecte comme utilisateur de démonstration et capture une page pour un article ressemble à ceci :
// docs/capture/billing.spec.ts
import { test } from '@playwright/test';

test('capture billing page for the invoices article', async ({ page }) => {
  await page.goto('http://localhost:3000/login');
  await page.getByLabel('Email').fill('docs-demo@example.com');
  await page.getByLabel('Password').fill(process.env.DOCS_DEMO_PASSWORD!);
  await page.getByRole('button', { name: 'Sign in' }).click();

  await page.goto('http://localhost:3000/settings/billing');
  await page.screenshot({ path: 'docs/img/download-invoices-step-1.png' });
});
La documentation Playwright sur les captures d’écran couvre les captures d’un seul élément et les captures de page entière. Le plus difficile n’est pas le script, c’est de disposer de données de démonstration réalistes et d’une connexion qui fonctionne en intégration continue. Nous détaillons toute la mise en place dans comment créer automatiquement des captures d’écran de votre produit.
Pourquoi la relecture humaine reste indispensable
Même avec un bon ancrage, quelqu’un qui connaît le produit doit lire chaque article avant sa mise en ligne. Pas le survoler. Le lire.
Voici la liste de contrôle que je donnerais à un relecteur :
- Les mots correspondent à l’interface. Chaque nom de fonctionnalité, de bouton et d’élément de menu est celui que voient les clients, pas celui qu’emploient les ingénieurs.
- Chaque écran est accessible. Un client sur l’offre visée par l’article peut réellement y arriver. Les fonctionnalités propres à une offre le précisent.
- L’article part de la tâche. Le titre est ce qu’un utilisateur taperait dans une recherche. La première étape est un clic, pas un paragraphe de contexte.
- Les politiques sont réelles. Tout ce qui touche à l’argent, aux données, à la résiliation ou aux horaires de support vient de vous, pas du modèle.
- Rien d’inédit. Aucune fonctionnalité bêta, aucun outil interne, aucun nom que le marketing n’a pas annoncé.
Relire un brouillon correct est bien plus rapide que d’écrire à partir d’une page blanche, et c’est tout l’intérêt. Mais c’est l’étape qui transforme un brouillon plausible en documentation que vous assumez. Si vous la sautez, vous publiez les suppositions du modèle sous le nom de votre entreprise.
Un workflow maison à lancer avec votre assistant de programmation
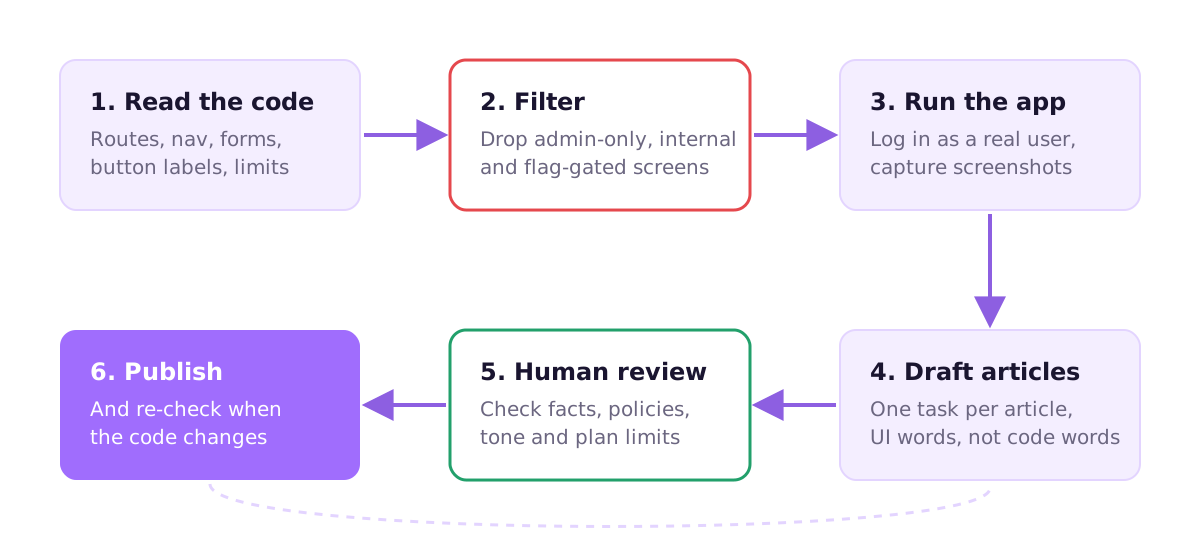
Vous n’avez pas besoin d’un générateur de documentation par IA dédié pour en tirer l’essentiel. Avec Cursor, Claude Code, Copilot ou un outil similaire :
1. Demandez un inventaire, pas des articles. Quelque chose comme :
List every user-facing feature in this app. For each one give:
- the route or screen where a user finds it
- the exact button/menu labels involved
- any plan, role or feature-flag check guarding it
Do not write documentation yet.
2. Élaguez-le à la main. Barrez les routes d’administration, les outils internes, les bêtas protégées par un drapeau et le code mort. Cela prend dix minutes et évite les pires erreurs.
3. Donnez-lui un glossaire. Une courte liste qui associe les termes du code à ceux de l’interface (workspace → Team, PRO_LEGACY → Pro). Collez-la dans chaque requête de rédaction.
4. Rédigez une tâche par article. Demandez un guide pratique écrit pour un utilisateur non technique, qui n’emploie que les intitulés de l’inventaire, commence par l’objectif et signale par [CHECK] toute phrase dont il n’est pas sûr.
5. Parcourez l’application et faites des captures. Suivez vous-même chaque article. Corrigez ce qui est faux, ajoutez les captures d’écran.
6. Relisez avec la liste de contrôle ci-dessus, puis publiez. Pour la structure, comment rédiger des articles de centre d’aide que les gens utilisent vraiment propose un modèle qui convient bien ici.
Le point faible de la voie maison est l’étape 7, qui n’existe pas encore : s’apercevoir que la modification de code de la semaine prochaine rend l’article douze faux. C’est un problème à part, traité dans comment garder votre documentation à jour.
Comment Ellie Docs gère cela
Nous avons conçu Ellie Docs autour des défauts décrits plus haut, voici donc comment il y répond.
Il lit votre dépôt, cartographie les fonctionnalités et les écrans visibles par les utilisateurs, puis rédige un centre d’aide organisé selon ce que font les utilisateurs.
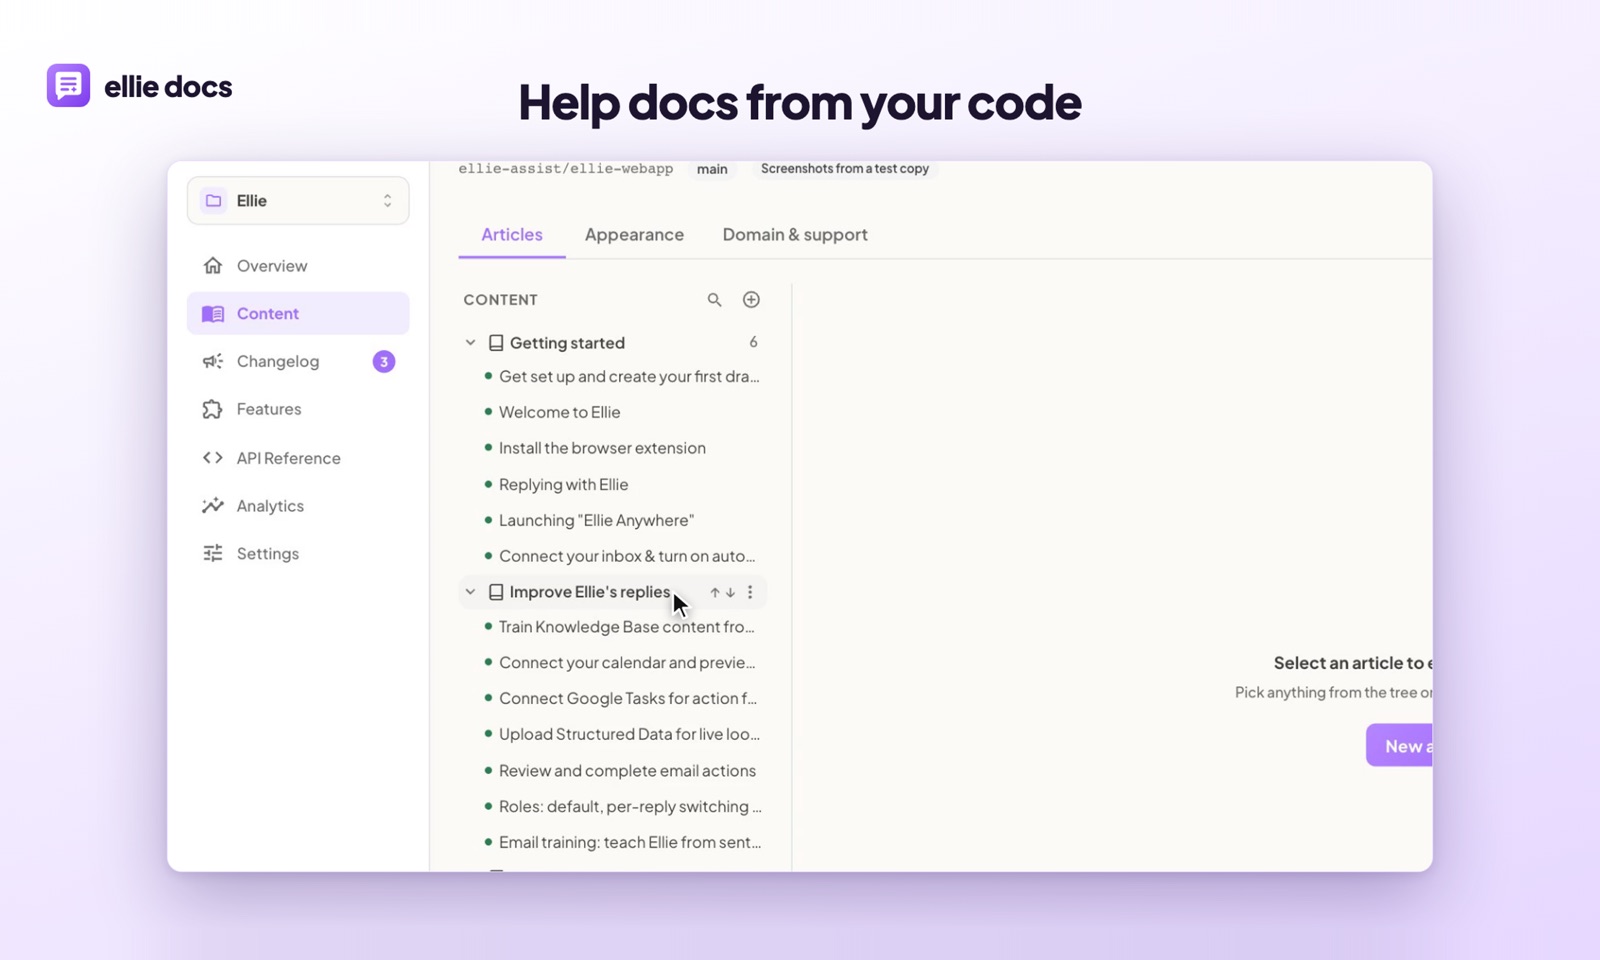
Il exécute votre application dans un bac à sable et capture de vraies captures d’écran du produit connecté, placées dans les articles. Chaque article indique les fonctionnalités sur lesquelles il s’appuie, si bien que lorsque ces fonctionnalités changent dans le code, Ellie sait que l’article peut être touché.

À chaque pull request fusionnée, il vérifie quels articles sont concernés par la modification et propose des corrections sous forme de diff que vous acceptez ou rejetez. Quand il rédige votre changelog à partir des pull requests fusionnées, il retient les entrées concernant du travail non publié ou protégé par un drapeau. Rien ne se publie tout seul. C’est vous qui publiez.
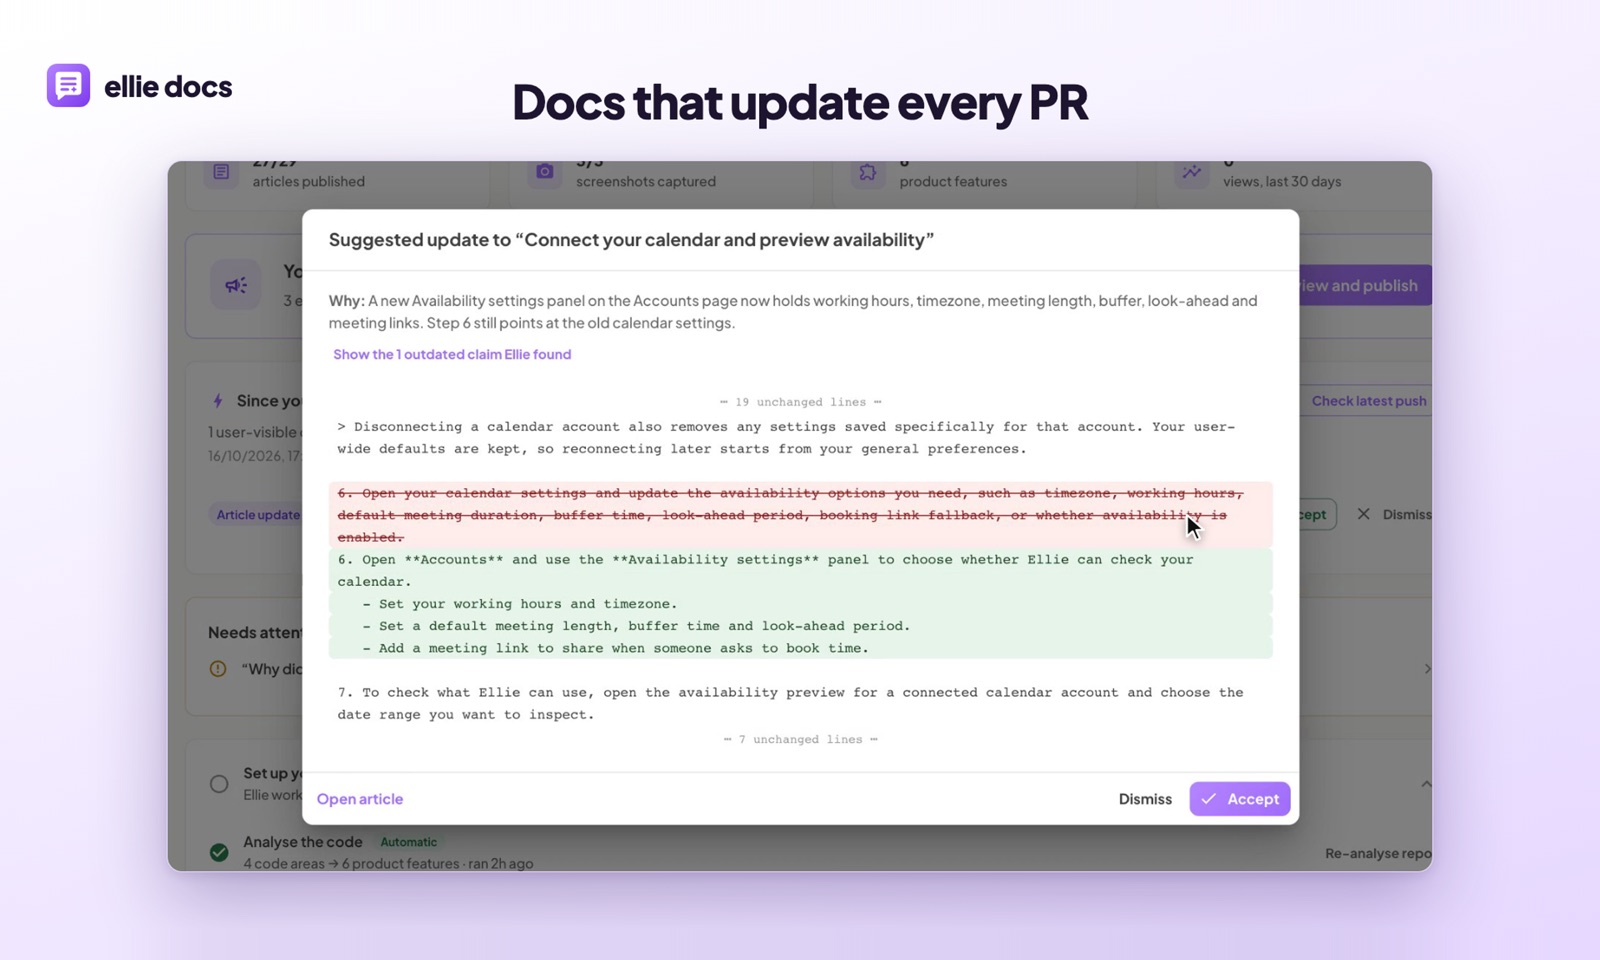
Il lui arrive encore de se tromper. Il ne peut pas connaître vos politiques, et il choisira parfois un mot du code plutôt qu’un mot de l’interface. C’est pourquoi chaque brouillon et chaque suggestion passe par vous. Si vous travaillez sur une application créée avec un outil de génération par IA, le guide pour documenter une application créée en « vibe coding » couvre les subtilités supplémentaires.
Quelques questions fréquentes
Existe-t-il un générateur de documentation par IA gratuit ? Votre assistant de programmation, avec le workflow maison ci-dessus, ne coûte rien de plus. Ellie Docs propose aussi une offre gratuite sans carte bancaire, si vous préférez que les captures d’écran et le suivi des mises à jour soient pris en charge.
L’IA peut-elle générer une documentation d’API sans spécification OpenAPI ? Oui, en lisant vos gestionnaires de routes. Si vous avez déjà une spécification, utilisez des outils standards comme Swagger UI ou Redoc : c’est déterministe et gratuit. Ellie Docs génère une référence d’API à partir du code, sans spécification, avec son offre Growth, ce qui aide si vous n’en avez jamais écrit.
Dois-je laisser l’IA publier la documentation automatiquement ? Non. Laissez-la rédiger et proposer. Une personne qui connaît le produit doit approuver tout ce que les clients liront, surtout ce qui touche à la facturation ou aux données.
Une documentation écrite par l’IA sera-t-elle exacte ? Aussi exacte que l’ancrage et la relecture dont elle bénéficie. À partir du code seul, attendez-vous à un brouillon utile avec des erreurs assurées. Ancrée dans l’application en fonctionnement et relue par quelqu’un qui connaît le produit, elle peut être meilleure que ce que la plupart des équipes écrivent à la main, surtout parce qu’elle couvre des fonctionnalités que les humains ont oubliées.
Si vous voulez des brouillons ancrés dans votre vraie application, avec des captures d’écran et des suggestions à chaque pull request que vous approuvez, essayez Ellie Docs gratuitement. Connectez un dépôt et relisez dès aujourd’hui votre premier centre d’aide rédigé.