
Генерация документации из кода: что ИИ делает правильно, а что нет
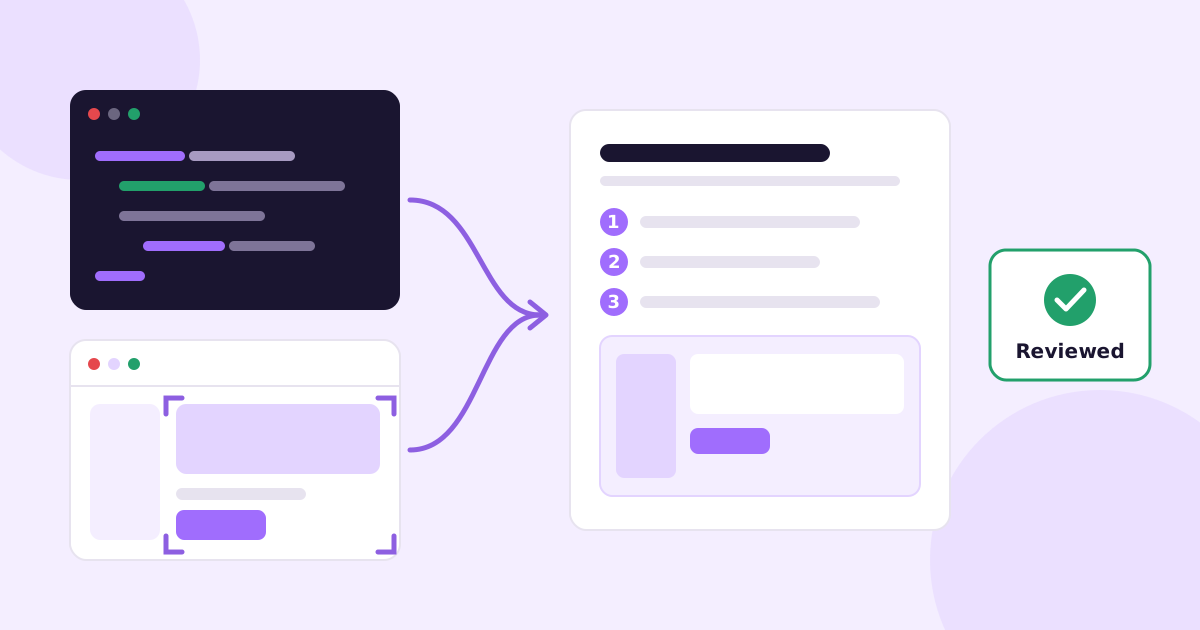
Направьте модель на репозиторий, попросите центр помощи, и вы его получите. Он будет выглядеть законченным. А потом вы читаете четвёртую статью, и там клиентам рассказывают про PlanTier.PRO_LEGACY и экран по адресу /admin/impersonate.
Так может ли ИИ сгенерировать документацию из кода? Да, и черновики получаются полезными. ИИ хорошо находит все функции, точно воспроизводит названия кнопок и делает единообразную первую версию. Но «из коробки» он стабильно ошибается в трёх вещах: просачивает внутренний жаргон, документирует экраны, которых пользователи не видят, и описывает код вместо задачи, которую решает пользователь. Решение в том, чтобы опирать черновики на работающее приложение и поручать человеку проверку всего перед публикацией.
Ниже разберём, почему так происходит и как всё настроить, чтобы результат стоило выпускать.
Два совершенно разных вида «документации из кода»
Под этим запросом люди подразумевают две разные вещи, и их стоит разделить.
Справочная документация для разработчиков. Справочники по API, документация SDK, сигнатуры функций. Эта задача в основном решена и вообще не требует ИИ. TypeDoc, Sphinx autodoc, Javadoc и инструменты на базе OpenAPI вроде Swagger UI читают ваш код или спецификацию и детерминированно формируют справочные страницы. Они скучны и надёжны, а именно этого и ждёшь от справочной документации.
Пользовательская документация. Статьи центра помощи для людей, которые никогда не увидят ваш код: «как выгрузить счета», «как добавить коллегу». Это трудная задача, и именно здесь ИИ-генераторы документации сегодня по-настоящему полезны и по-настоящему рискованны.
Эта статья о втором виде. Если вам нужен README или комментарии в коде, ваш помощник по программированию уже справляется с этим достаточно хорошо.
Что ИИ делает хорошо, когда создаёт пользовательскую документацию из кода
Отдадим должное. Модель, читающая кодовую базу, справляется с несколькими конкретными задачами лучше человека.
Она находит всё
Люди пишут документацию по памяти, а память забывает функции. Импорт CSV, который кто-то сделал восемь месяцев назад. Сочетание клавиш. Настройка, которая появляется только на тарифе для команд. Модель, прочитавшая файл маршрутов, компоненты навигации и формы, составляет полный перечень, и ради одного этого перечня упражнение стоит затраченных усилий. В большинстве центров помощи есть пробелы, о которых никто не знает.
Она точно воспроизводит названия
Текст кнопок прямо в коде: "Export CSV", "Send invite". Модель процитирует его дословно, тогда как человек напишет «нажмите кнопку экспорта» и оставит читателя гадать.
Она замечает ограничения и правила
Правила проверки живут в коде. Максимальная длина названия проекта, лимит размера файла, проверка роли, из-за которой кнопка становится серой. Это именно те детали, из-за которых возникают обращения в поддержку («почему я не могу это сохранить?»), и именно те детали, о которых автор-человек не знает.
Что ИИ делает неправильно, когда генерирует документацию из кода
Об этом большинство инструментов не пишет на своих посадочных страницах. По моему опыту, эти сбои встречаются почти в каждом сыром черновике ИИ.
1. Просачивается внутренний жаргон
В вашем коде и интерфейсе используются разные слова. Таблица называется workspaces, а в интерфейсе написано «Команда». Перечисление называется PlanTier.PRO_LEGACY, а на странице цен написано «Pro». Функция целый год называлась внутри smartRouting, пока маркетинг не дал ей название «Автоназначение».
Модель читает код, поэтому использует слова из кода. Получаются фразы вроде «Создайте новое рабочее пространство (org) на странице Teams», которые сбивают клиентов с толку и к тому же неверны. Хуже того, в них просачиваются названия, которые вы не собирались делать публичными.
2. Она документирует экраны, которых пользователи не видят
Модель видит маршрут и пишет для него статью. Она не знает, что:
/admin/*— это ваши внутренние инструменты поддержки- страница «Массовый импорт» скрыта за флагом функции, включённым у трёх бета-аккаунтов
- настройки «Команды» отображаются только на тарифе Business
- старый сценарий онбординга — мёртвый код, который никто не удалил
Поэтому она пишет статьи справки обо всём этом. В лучшем случае клиенты ищут экраны, которых для них не существует, и пишут вам. В худшем вы публикуете свою дорожную карту или инструкцию по внутреннему инструменту имитации администратора.
3. Она описывает код, а не задачу пользователя
Это тонкая и самая частая проблема. Модель объясняет, что делает код, потому что смотрит на него. Пользователей не интересует, что делает код. Они хотят решить задачу.
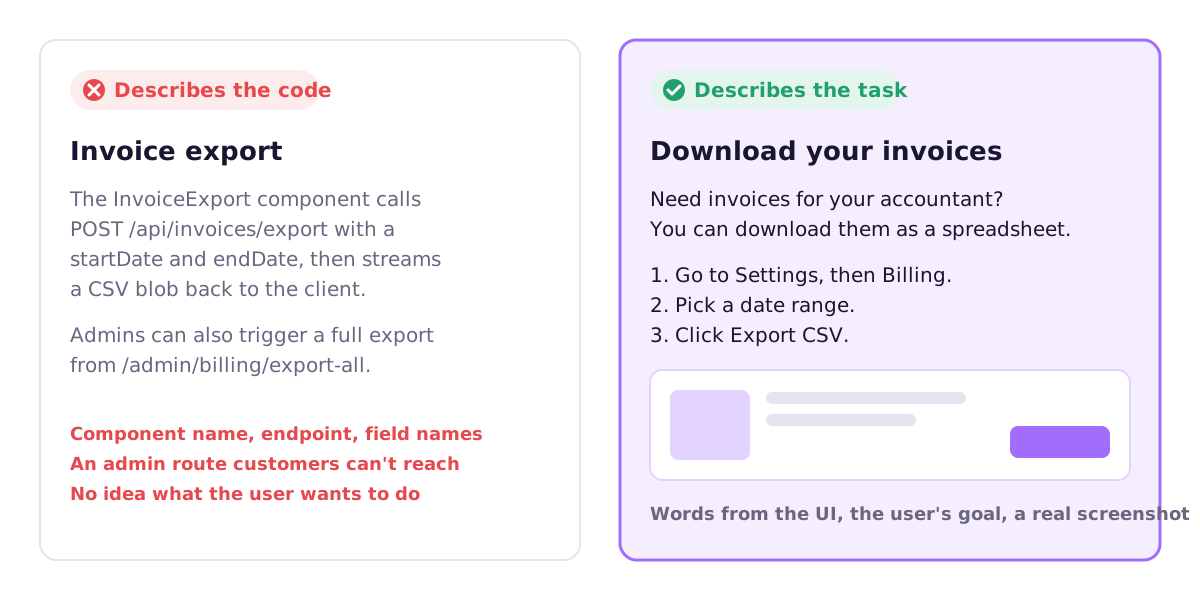
Левая версия точна. Но она бесполезна для человека, которому бухгалтер только что запросил счета за прошлый квартал. Правая версия исходит из цели, использует слова с экрана и показывает, куда нажимать. Фреймворк Diátaxis хорошо проводит эту границу: руководство «как сделать» служит цели, справочник описывает механизм. Сырые черновики ИИ сползают к справочнику, даже если вы просили инструкцию.
4. Она уверенно гадает о поведении, которое код не определяет
Многое из того, что видит пользователь, определяется не только кодом. Отправится ли письмо с подтверждением, зависит от конфигурации. Как выглядит страница, зависит от данных на ней. Ваша политика возвратов, часы работы поддержки и судьба данных после отмены подписки обычно вообще не хранятся в репозитории.
Модель заполняет эти пробелы правдоподобными догадками, написанными тем же уверенным тоном, что и всё остальное. В этом и опасность: неверные предложения ничем не отличаются от верных.
Почему важно опираться на работающее приложение
Код говорит, что может существовать. Работающее приложение показывает, что пользователь на самом деле видит.
Если вы генерируете документацию только из кода, вы документируете теорию о своём продукте. Запустите приложение, войдите как обычный пользователь на обычном тарифе, и большинство перечисленных проблем уменьшатся:
- Административные экраны и экраны за флагами просто не появятся, а значит, не будут задокументированы.
- Названия на скриншоте совпадают с теми, которые видят клиенты, и это отлавливает жаргон.
- Если в статье сказано «нажмите Export CSV», а на скриншоте кнопки экспорта нет, вы нашли ошибку (в документации или в продукте) раньше клиента.
Это можно сделать самостоятельно с помощью инструмента автоматизации браузера. Минимальный скрипт на Playwright, который входит как демо-пользователь и снимает страницу для статьи, выглядит так:
// docs/capture/billing.spec.ts
import { test } from '@playwright/test';

test('capture billing page for the invoices article', async ({ page }) => {
  await page.goto('http://localhost:3000/login');
  await page.getByLabel('Email').fill('docs-demo@example.com');
  await page.getByLabel('Password').fill(process.env.DOCS_DEMO_PASSWORD!);
  await page.getByRole('button', { name: 'Sign in' }).click();

  await page.goto('http://localhost:3000/settings/billing');
  await page.screenshot({ path: 'docs/img/download-invoices-step-1.png' });
});
Документация Playwright по скриншотам описывает снимки отдельных элементов и полных страниц. Сложность не в скрипте, а в наличии демо-данных, которые выглядят реалистично, и входа, который работает в CI. Всю настройку мы разбираем в статье как автоматически создавать скриншоты продукта.
Почему проверка человеком по-прежнему обязательна
Даже при хорошей опоре на реальное приложение кто-то, кто знает продукт, должен прочитать каждую статью перед публикацией. Не пролистать. Прочитать.
Вот чек-лист, который я бы дал рецензенту:
- Слова совпадают с интерфейсом. Каждое название функции, кнопки и пункта меню такое, каким его видят клиенты, а не таким, каким его называют инженеры.
- Каждый экран достижим. Клиент на тарифе, для которого написана статья, действительно может туда попасть. Функции конкретных тарифов помечены как таковые.
- Статья начинается с задачи. Заголовок — то, что пользователь ввёл бы в поиск. Первый шаг — это клик, а не абзац предыстории.
- Политики настоящие. Всё, что касается денег, данных, отмены подписки или часов работы поддержки, исходит от вас, а не от модели.
- Ничего невыпущенного. Никаких бета-функций, внутренних инструментов и названий, которые маркетинг ещё не объявил.
Проверять приличный черновик гораздо быстрее, чем писать с чистого листа, и в этом весь смысл. Но именно этот шаг превращает правдоподобный черновик в документацию, за которую не стыдно отвечать. Если его пропустить, вы публикуете догадки модели под именем своей компании.
Самостоятельный процесс, который можно запустить с помощником по программированию
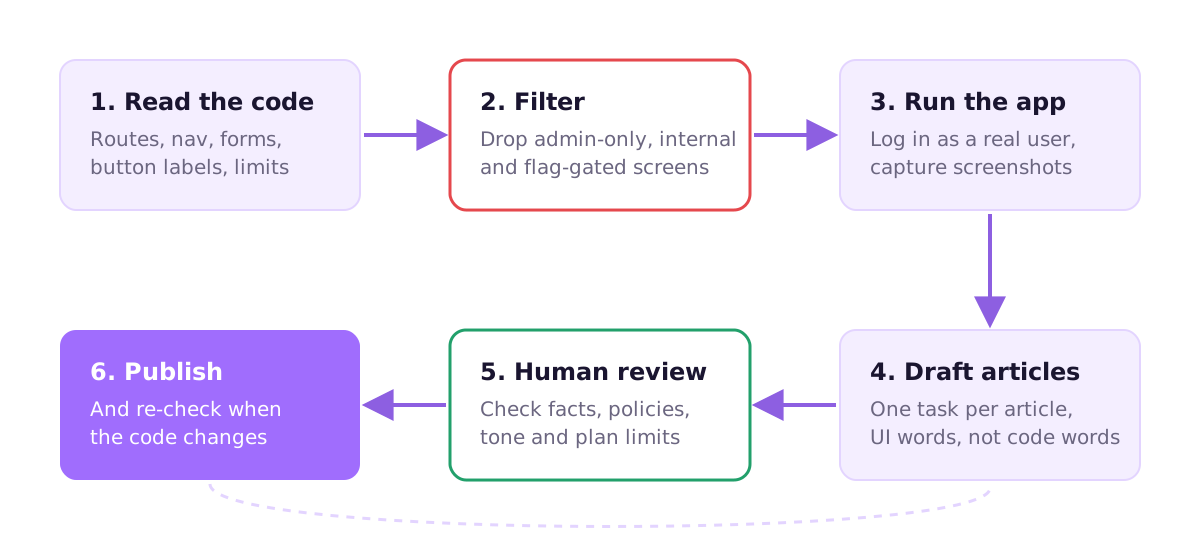
Чтобы получить большую часть пользы, специальный ИИ-генератор документации не нужен. Достаточно Cursor, Claude Code, Copilot или аналогичного инструмента:
1. Просите перечень, а не статьи. Примерно так:
List every user-facing feature in this app. For each one give:
- the route or screen where a user finds it
- the exact button/menu labels involved
- any plan, role or feature-flag check guarding it
Do not write documentation yet.
2. Почистите его вручную. Вычеркните административные маршруты, внутренние инструменты, бета-функции за флагами и мёртвый код. Это занимает десять минут и предотвращает самые серьёзные сбои.
3. Дайте ему глоссарий. Короткий список соответствий терминов из кода терминам интерфейса (workspace → Team, PRO_LEGACY → Pro). Вставляйте его в каждый запрос на составление черновика.
4. Одна задача на статью. Просите инструкцию «как сделать» для нетехнического пользователя, использующую только названия из перечня, начинающуюся с цели и помечающую любое сомнительное предложение маркером [CHECK].
5. Пройдите по приложению и сделайте скриншоты. Выполните каждую статью сами. Исправьте ошибки, добавьте скриншоты.
6. Проверьте по чек-листу выше и публикуйте. Что касается структуры, у материала как писать статьи для центра помощи, которыми действительно пользуются есть подходящий шаблон.
Слабое место самостоятельного пути — шаг 7, которого пока не существует: заметить, что изменение кода на следующей неделе делает неверной двенадцатую статью. Это отдельная проблема, о ней рассказано в статье как поддерживать документацию в актуальном состоянии.
Как с этим справляется Ellie Docs
Мы создали Ellie Docs с учётом перечисленных сбоев, и вот как это выглядит.
Она читает ваш репозиторий, сопоставляет функции и экраны, видимые пользователям, а затем составляет черновик центра помощи, организованного по действиям пользователей.
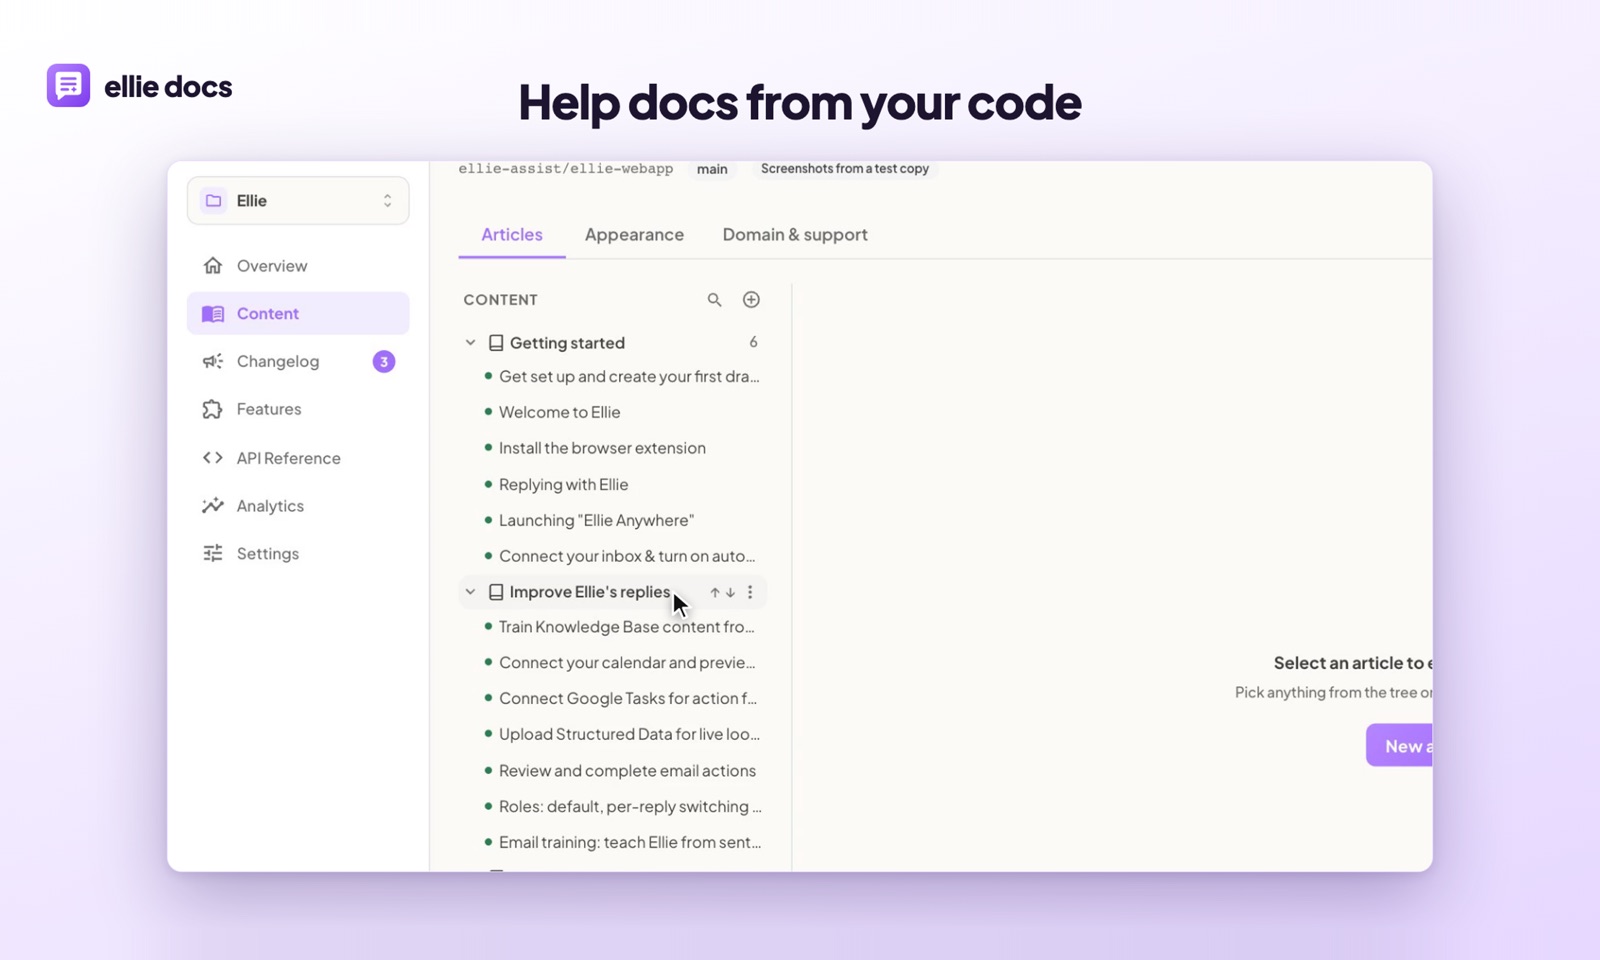
Она запускает ваше приложение в песочнице и снимает настоящие скриншоты продукта под учётной записью пользователя, размещая их в статьях. Каждая статья показывает, на каких функциях она основана, поэтому когда эти функции в коде меняются, Ellie знает, что статья может быть затронута.

После каждого слитого PR она проверяет, какие статьи затрагивает изменение, и предлагает правки в виде диффа, который вы принимаете или отклоняете. Когда она пишет ваш список изменений по слитым PR, она придерживает записи о невыпущенной работе и работе за флагами. Ничего не публикуется само. Публикуете вы.
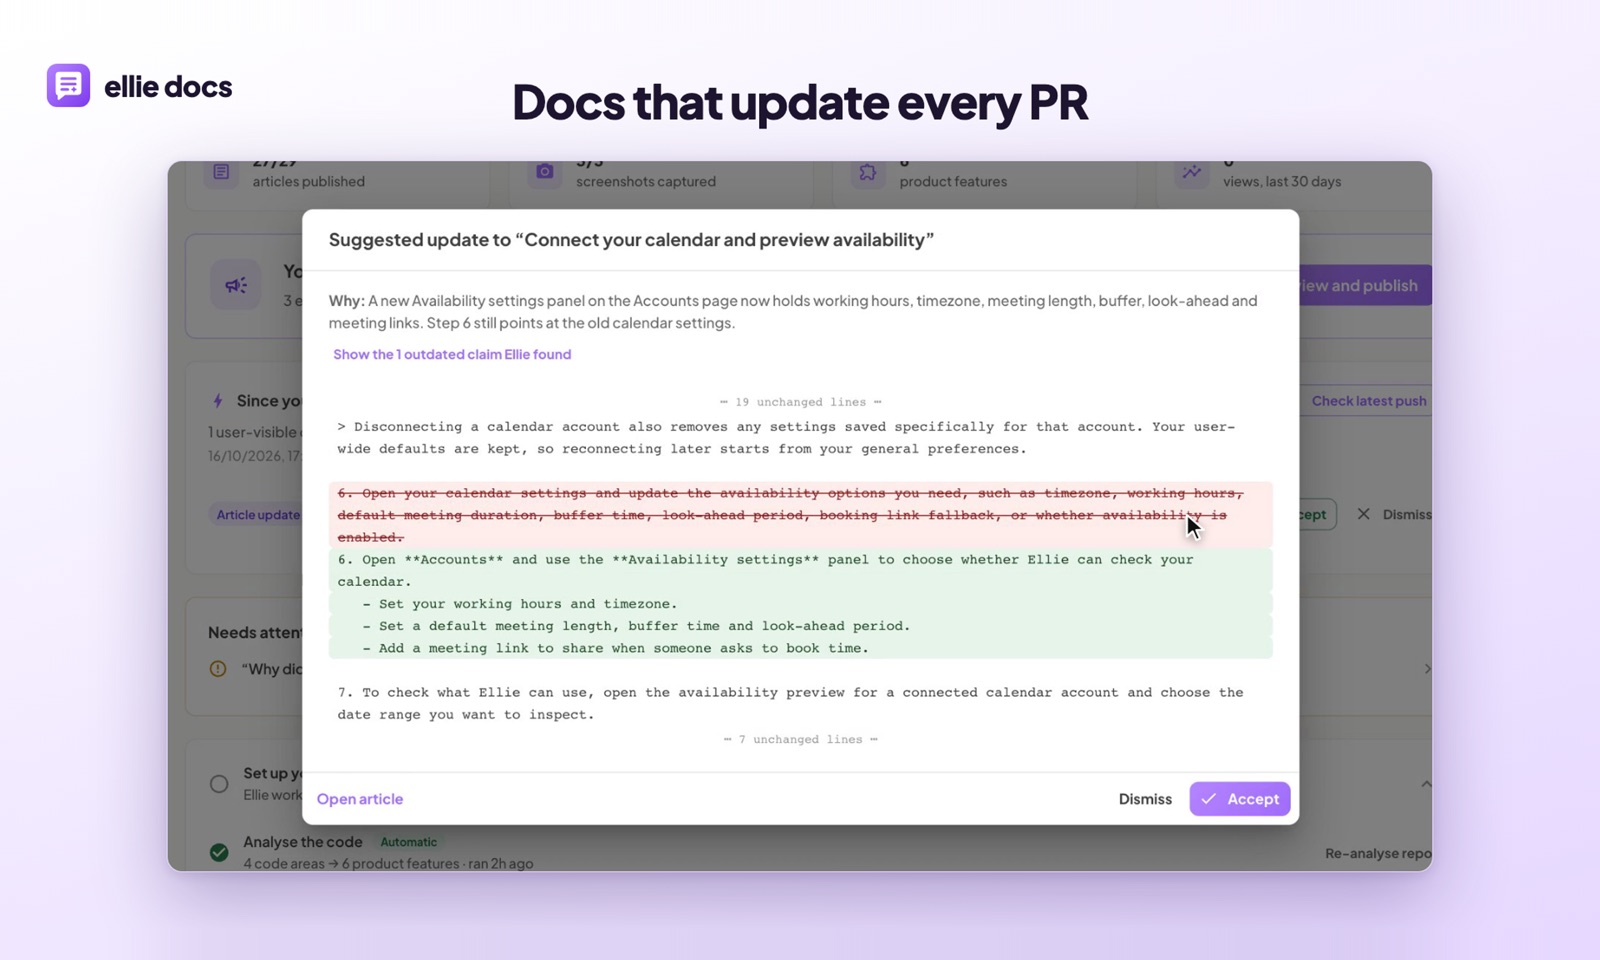
Иногда она всё же ошибается. Она не может знать ваши политики и порой выберет слово из кода вместо слова из интерфейса. Поэтому каждый черновик и каждое предложение проходит через вас. Если вы работаете над приложением, созданным в ИИ-конструкторе, руководство о документировании приложения, созданного в стиле vibe coding описывает дополнительные тонкости.
Несколько вопросов, которые задают чаще всего
Есть ли бесплатный ИИ-генератор документации? Ваш помощник по программированию вместе с описанным выше самостоятельным процессом не стоит ничего дополнительно. У Ellie Docs тоже есть бесплатный тариф без карты, если вы хотите, чтобы скриншоты и отслеживание обновлений были сделаны за вас.
Может ли ИИ сгенерировать документацию по API без спецификации OpenAPI? Может, прочитав обработчики маршрутов. Если спецификация у вас уже есть, используйте стандартные инструменты вроде Swagger UI или Redoc: они детерминированны и бесплатны. Ellie Docs генерирует справочник по API из кода без спецификации на тарифе Growth, что помогает, если вы её никогда не писали.
Стоит ли позволять ИИ публиковать документацию автоматически? Нет. Пусть он составляет черновики и предлагает правки. Всё, что прочитают клиенты, особенно касающееся оплаты или данных, должен утвердить человек, знающий продукт.
Будет ли документация, написанная ИИ, точной? Настолько точной, насколько хороши опора на реальное приложение и проверка. Из одного кода ждите полезный черновик с уверенными ошибками. Если же она опирается на работающее приложение и проверена человеком, знающим продукт, она может быть лучше того, что большинство команд пишет вручную, главным образом потому, что охватывает функции, которые люди забыли.
Если вам нужны черновики, основанные на вашем реальном приложении, со скриншотами и предложениями по каждому PR, которые вы утверждаете, попробуйте Ellie Docs бесплатно. Подключите репозиторий и проверьте свой первый черновик центра помощи уже сегодня.